 datzin
claude-decide funciona porque un modelo pequeño contesta bien una sola pregunta: ¿este elemento instalado sirve para esta petición? Ese modelo es laya-context-prefilter, Laya multilingual ajustada con LayaFT. Así se armaron sus datos.
Un catálogo de lo que la gente instala
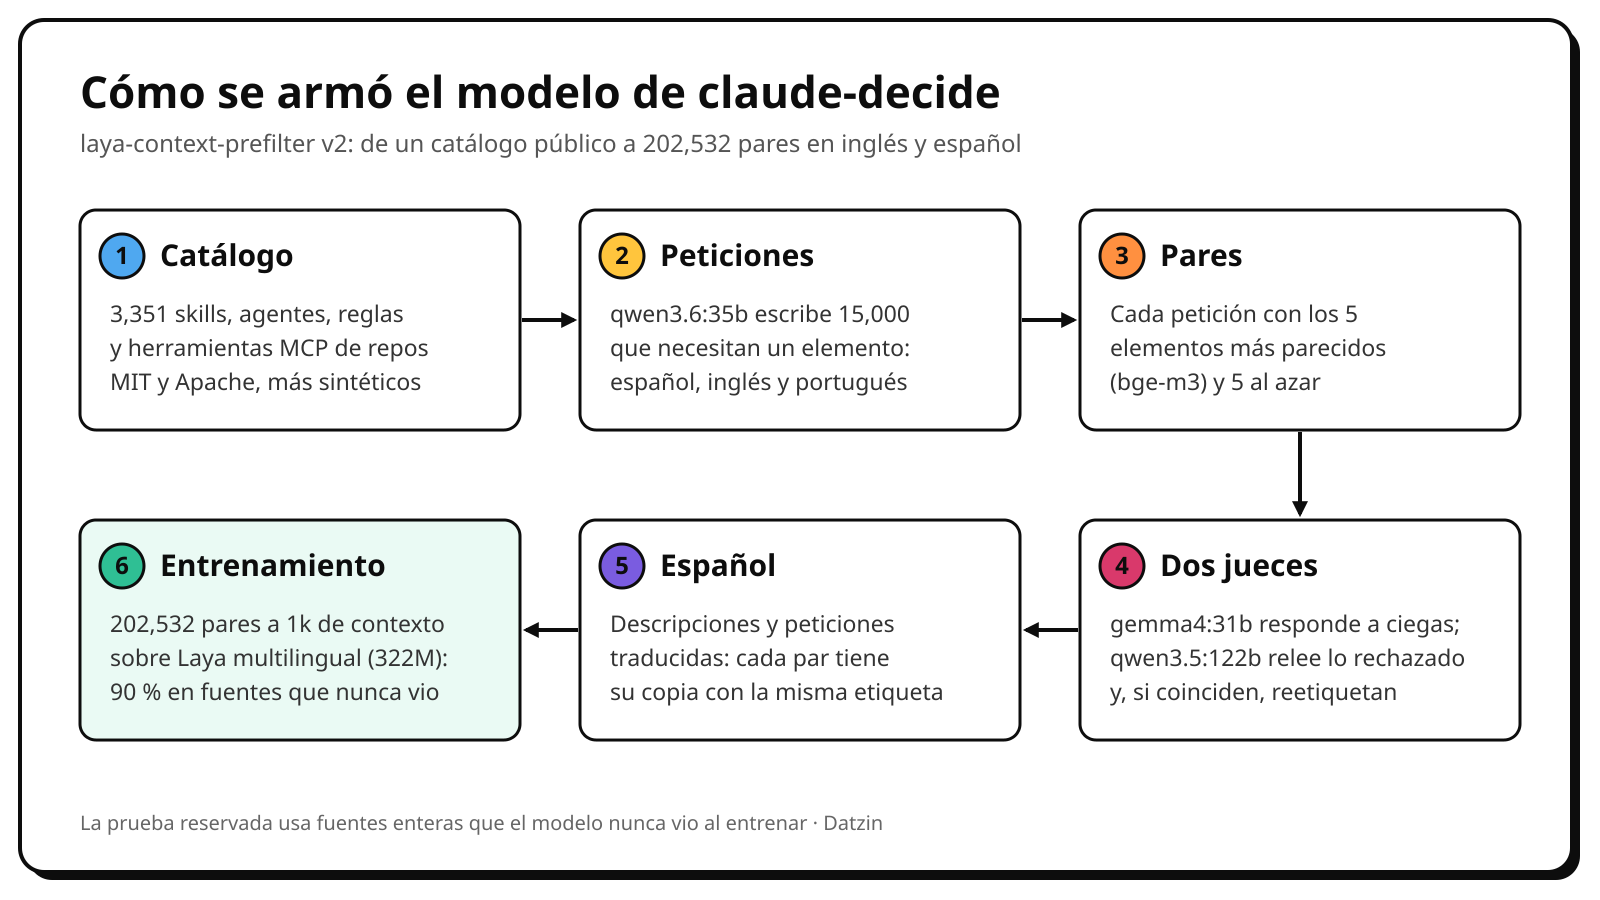
Primero junté lo que la gente de verdad instala: 3,351 skills, agentes, reglas y herramientas MCP de repositorios públicos con licencia MIT o Apache (el marketplace oficial de plugins de Anthropic, superpowers, wshobson/agents, claude-code-templates y el registro MCP de Docker, entre otros), más algunos sintéticos para los servidores que no listan sus herramientas. Con un tope de 400 elementos por repo y 20 por servidor, para que ninguna fuente se comiera a las demás. La idea es que aprenda a leer descripciones, no a memorizar nombres.
Peticiones escritas al revés
Igual que con los tickets, las etiquetas nacen con los datos: se sortea un elemento del catálogo y qwen3.6:35b escribe mensajes que un desarrollador le mandaría a Claude Code y que lo necesitan, o que casi lo necesitan. Fueron 15,000 peticiones en español, inglés y portugués, cortas y largas, recién llegadas o a mitad de un paso de herramienta. Y sin nombrar el elemento: «la pantalla de login se ve rara en el celular» necesita una skill de diseño frontend aunque no lo diga.
Negativos difíciles y dos jueces
Un sí es fácil de aprender si todos los no son obvios. Por eso cada petición también se empareja con los 5 elementos más parecidos según embeddings (bge-m3), que son los que confunden, y con 5 al azar. El problema es que a veces un vecino sí sirve, y ahí entran los jueces: gemma4:31b responde cada par a ciegas, qwen3.5:122b relee lo que gemma rechazó, y cuando los dos coinciden contra la etiqueta, su respuesta se vuelve la etiqueta.
Detalle técnico: todo corrió en un servidor con varias GPUs, partido en muchos trabajos chicos: generar, traducir y juzgar por pedazos, cada uno con su propio Ollama en una GPU. Con un solo Ollama compartido, que atendía dos peticiones a la vez, generar y juzgar era un cuello de botella.
Todo, también en español
Mucha gente le escribe a Claude en español (yo incluido), así que qwen3.6:35b tradujo cada descripción y cada petición que no estaba en español, y cada par ganó una copia en español con la misma etiqueta. Las dos copias comparten grupo, así que nunca queda una en entrenamiento y la otra en validación; eso es lo que trajo la 0.1.2 de LayaFT. En total, 202,532 pares, 104 mil en inglés y 98 mil en español, entrenados a 1k de contexto.
Cómo sé que no memorizó
Fuentes enteras se quedaron fuera del entrenamiento: los agentes de VoltAgent y el 15 % de los servidores MCP. Con ellas salió una prueba de 3,120 pares, verificada por los dos jueces, que el modelo nunca vio. Ahí acierta el 90 % (la base, 41 %) con un Brier de 0.074, y con todo traducido al español, 89.9 %.
Y con peticiones reales: contra 39 peticiones etiquetadas a mano y un catálogo de 49 elementos, la v2 pone el elemento correcto en primer lugar el 92 % de las veces (la v1, 86 %; la base, 33 %). Con un umbral de 0.5, a una petición que no necesita nada no le llega nada, y a las demás les llegan 2.5 elementos en promedio, con precisión de 0.48 y recall de 0.86. Lo que todavía no sabe es en qué proyecto está: por eso en los pasos de herramienta se le cuela ruby-pro, como conté en el post de claude-decide.
El modelo está en Hugging Face con la licencia Apache-2.0 de Laya, y la v1 sigue ahí como @v1. Si quieren uno para su propio catálogo, el patrón de «una pregunta por candidato» de LayaFT es el mismo que usé aquí. Y si le encuentran peticiones donde se equivoca feo, mándenmelas: son justo las que sirven para la siguiente versión.