 datzin
Cuando comparé Laya, Jev y Luna con tickets de soporte, Laya base quedó abajo en acierto, y en la prueba de herramientas todavía se equivocaba seguido. En los dos posts dejé la misma pregunta en el aire: ¿qué pasa si la ajusto con ejemplos de la tarea? Ya la ajusté.
Tickets: de 12 a 17
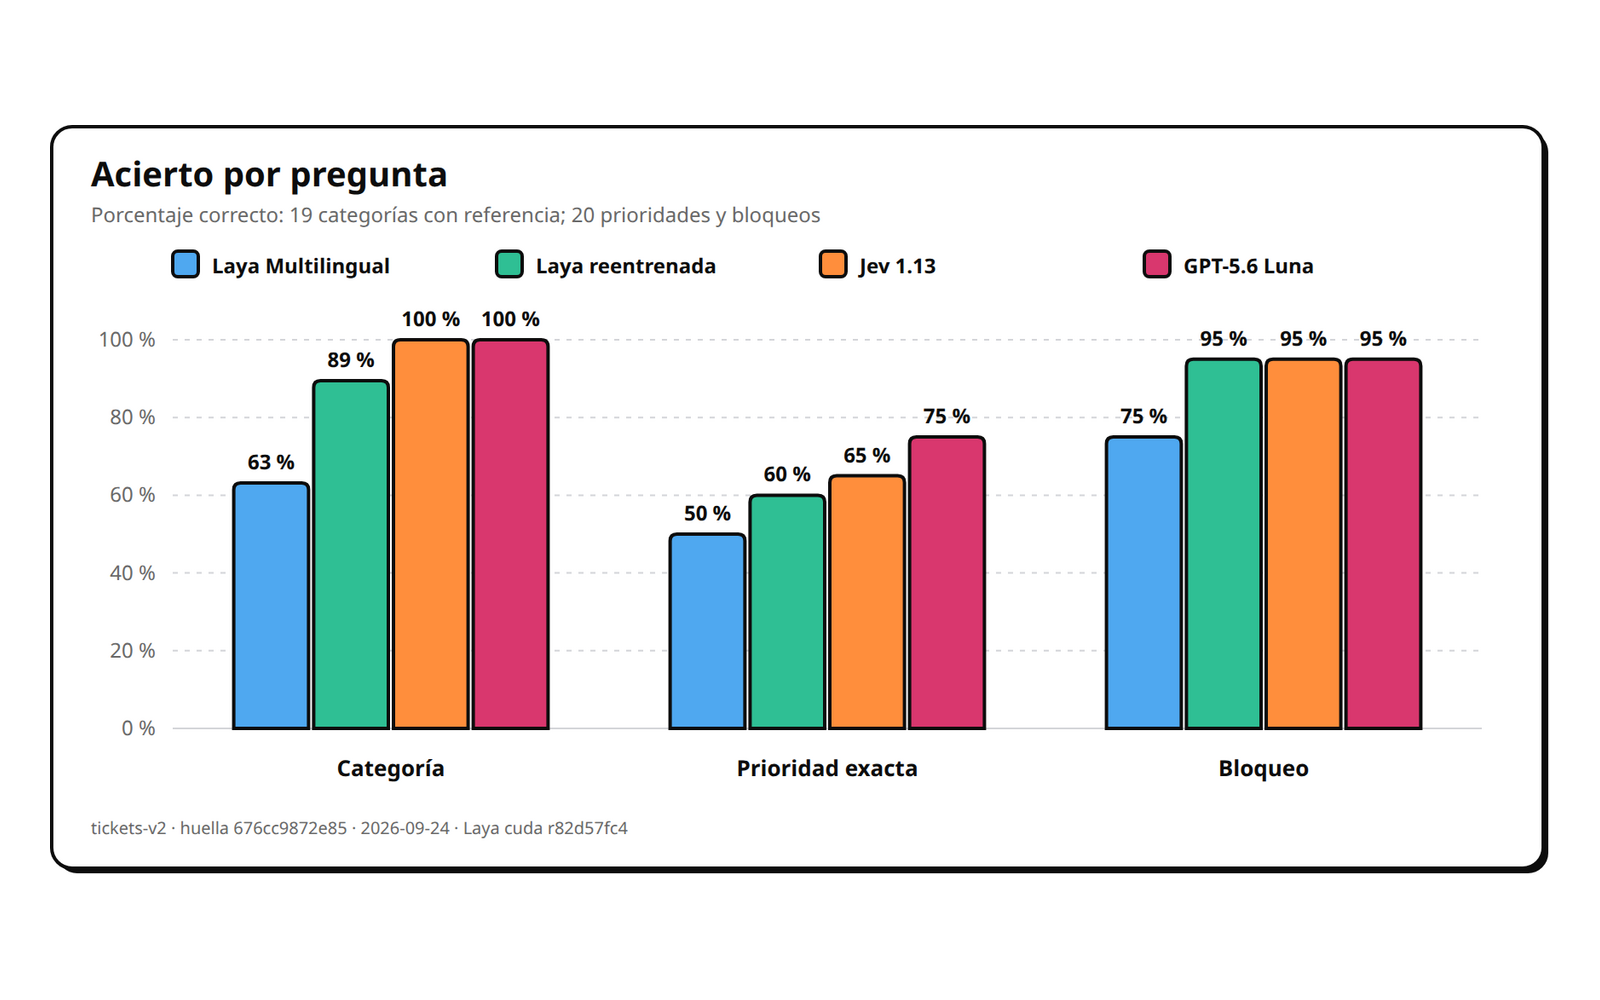
Son los mismos 20 tickets escritos a mano, que el modelo nunca vio al entrenar, con tres preguntas: categoría, prioridad y si la persona está bloqueada. La categoría pasó de 12 a 17 bien de 19 (Jev y Luna aciertan las 19). El bloqueo, de 15 a 19 de 20, igual que ellos. La prioridad exacta subió poco: de 10 a 12.
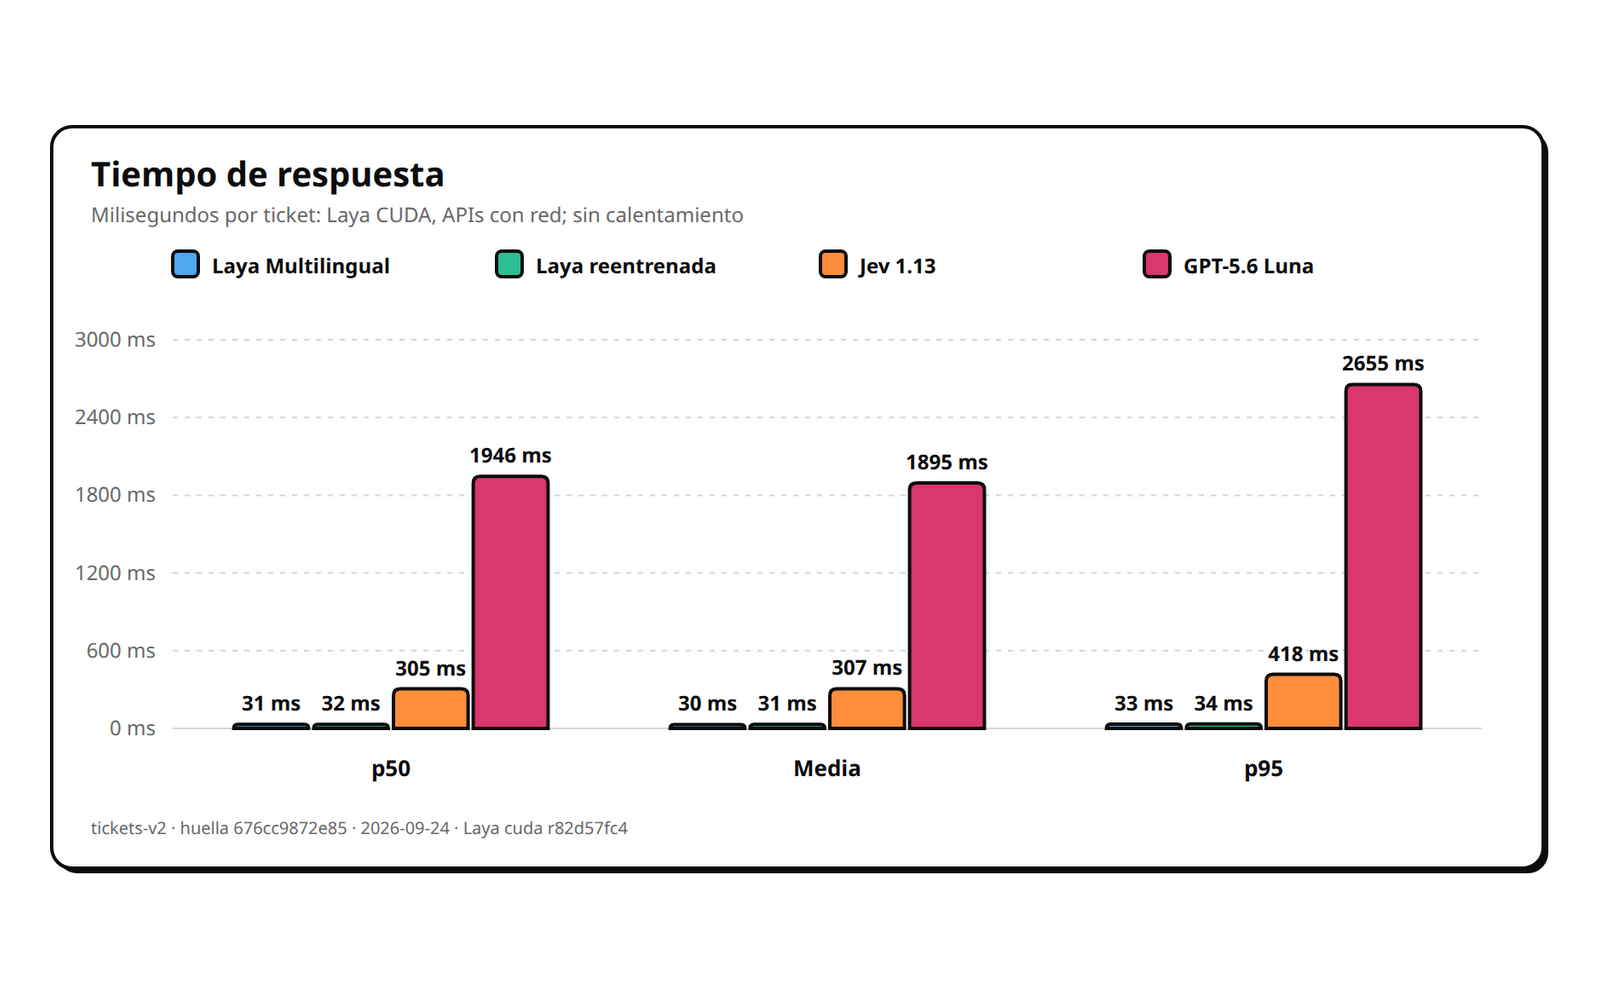
La velocidad no cambió: 32 ms por ticket en la GPU de mi laptop, contra 305 ms de Jev y casi 2 segundos de Luna, red incluida. Y el semáforo de la demo se volvió útil: en verde, sin revisión humana, pasó de 4 aciertos en 6 tickets a 15 en 17.
Detalle técnico: también mejoró la confianza. En el bloqueo, el Brier, que castiga equivocarse muy seguro, bajó de 0.178 a 0.042, a la par de Jev (0.048) y Luna (0.052).
Cuatro intentos
No salió a la primera: fueron cuatro versiones, y la categoría pasó por 79, 74 y 79 % antes del 89 %. Lo que más movió la aguja no fue tener más tickets, sino que estuvieran escritos de formas distintas: más contextos, estilos y modelos escribiéndolos.
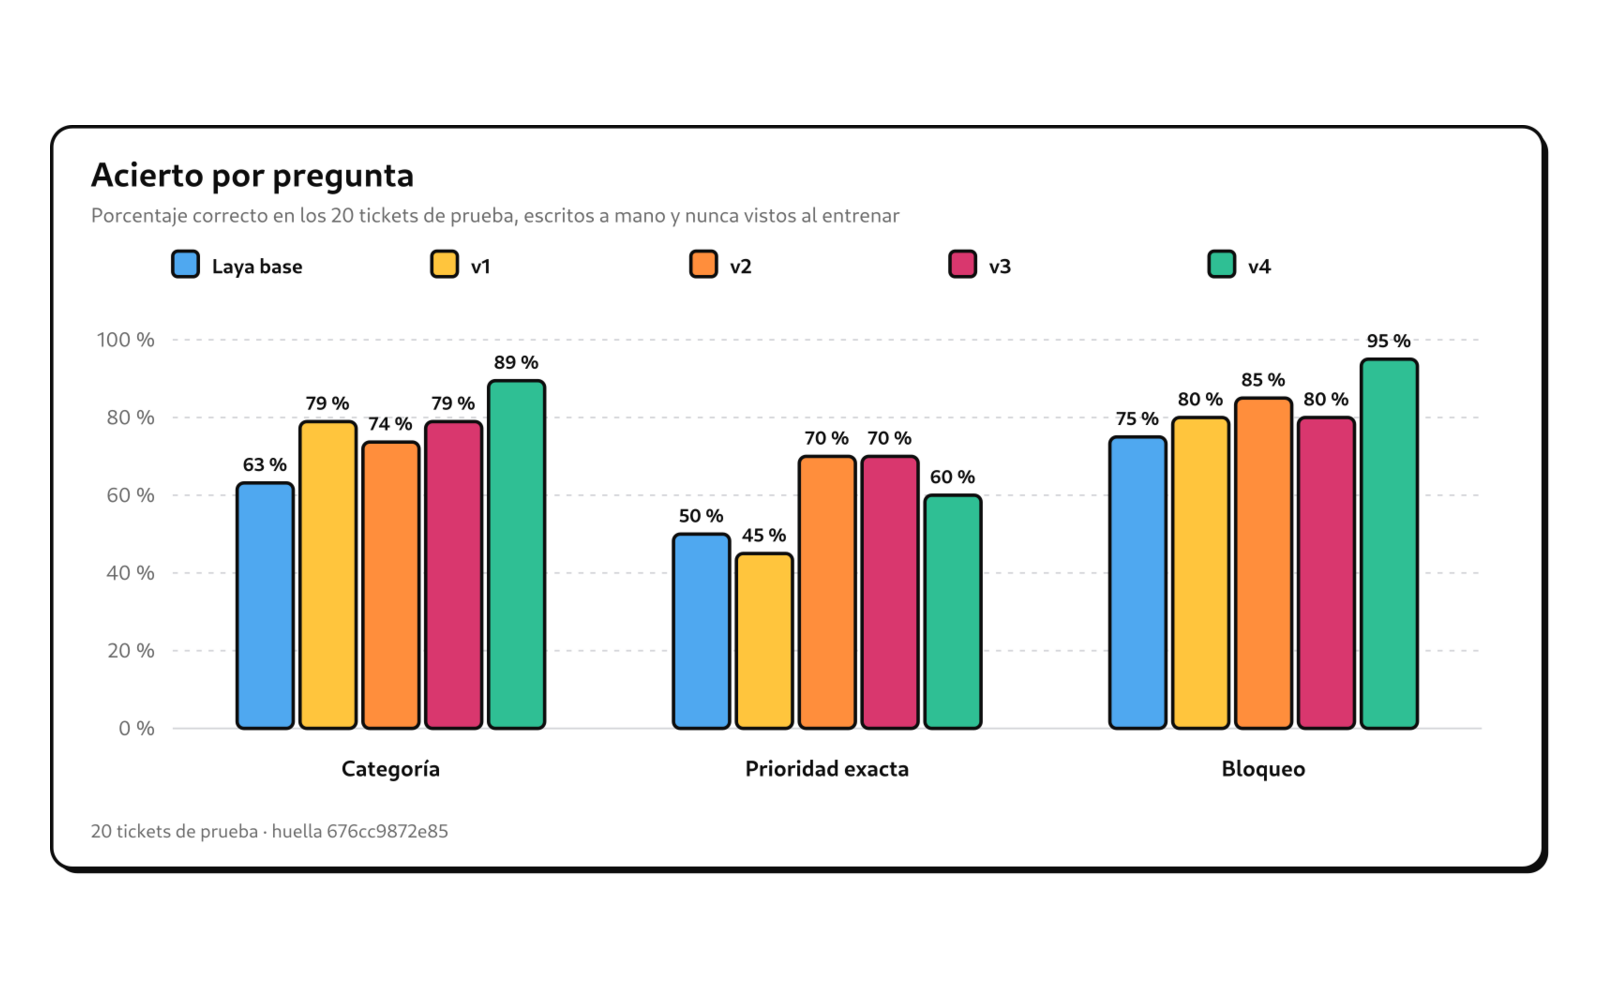
Otra lección: la validación sintética engaña. La versión final sacaba 1,158 de 1,160 ahí y 17 de 19 en tickets de verdad.
Los datos se escriben al revés
Para entrenar hacían falta miles de tickets etiquetados, y yo tenía 20. Lo que funcionó fue darle la vuelta: en lugar de pedirle a un LLM que clasificara tickets, le pedí que escribiera tickets para una respuesta que yo ya había decidido. Así cada ticket nace etiquetado.
Mi tropiezo favorito: al principio, los tickets de seguridad no traían ninguna señal de ataque y Jev, que hacía de profesor, rechazó el 42 %. Pedir en el prompt las señales de cada categoría, como un correo que pide la contraseña o un pago que nadie reconoce, subió el acuerdo al 98 %. Al final fueron 11,837 tickets, escritos entre gemma3 en local y GPT-5.6 Luna, por unos $3.50 contando al profesor.
Detalle técnico: entrené con RLCD, la receta del notebook oficial de Laya, con Jev aportando el 30 % de cada etiqueta y, al final, una temperatura por tipo de pregunta para calibrar la confianza. Cuatro épocas de unos 5 minutos en una GPU de escritorio, con 6 GB de VRAM.
Herramientas: de 12 a 79 de 120
La segunda tarea fue la de filtrar herramientas: decidir si contestar, pedir datos o actuar, y cuáles de cinco herramientas usar. En la prueba original de 120 solicitudes, la misma con la que medí a Jev y Luna, la decisión completa pasó de 12 a 79 bien, y a 86 con la versión entrenada para 8k de contexto.
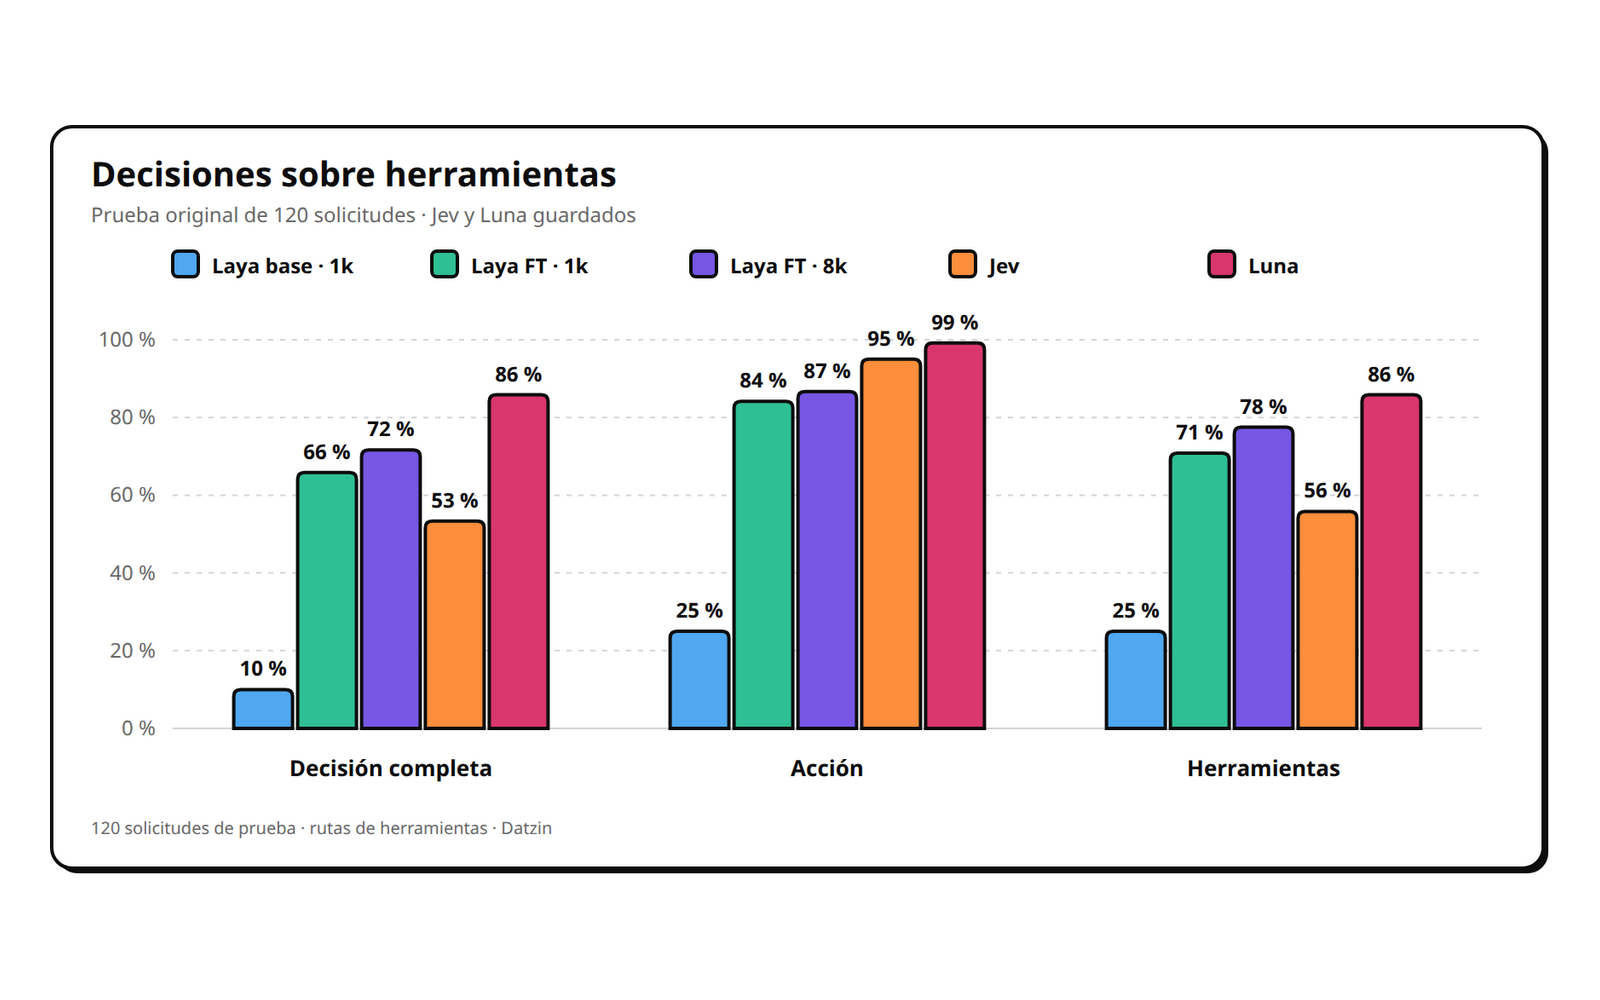
Le gana a Jev (64), pero Luna sigue arriba (103). Si solo se cuenta la acción, Jev acierta 114 y Luna 119, contra 101 y 104 de Laya. Eso sí, Laya responde en 27 ms; Jev tarda medio segundo y Luna, uno y medio.
Lo que no resolvió
Con el ticket al inicio de un hilo de correo con 8k tokens de relleno, la reentrenada sostiene el bloqueo entre 80 y 85 %, pero la prioridad baja en ambas y la latencia sube de 11 ms a unos 545 ms, casi lo mismo que Jev. Además, sus dos errores de categoría los comete muy segura: salen en verde y el semáforo no los atrapa.
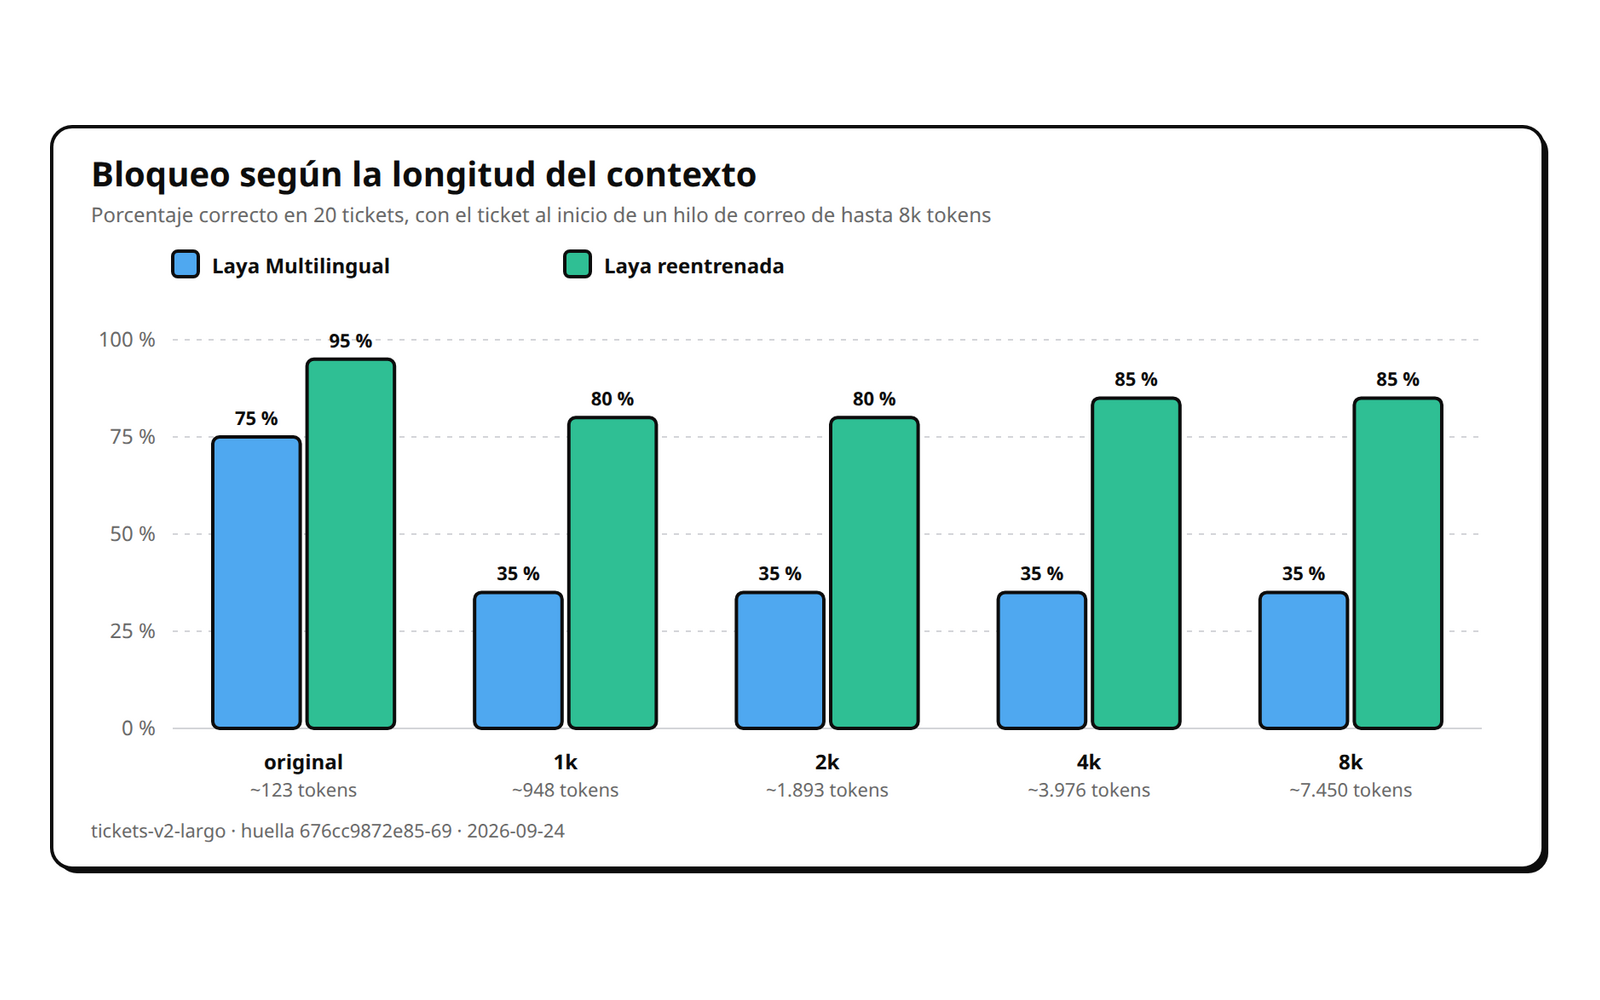
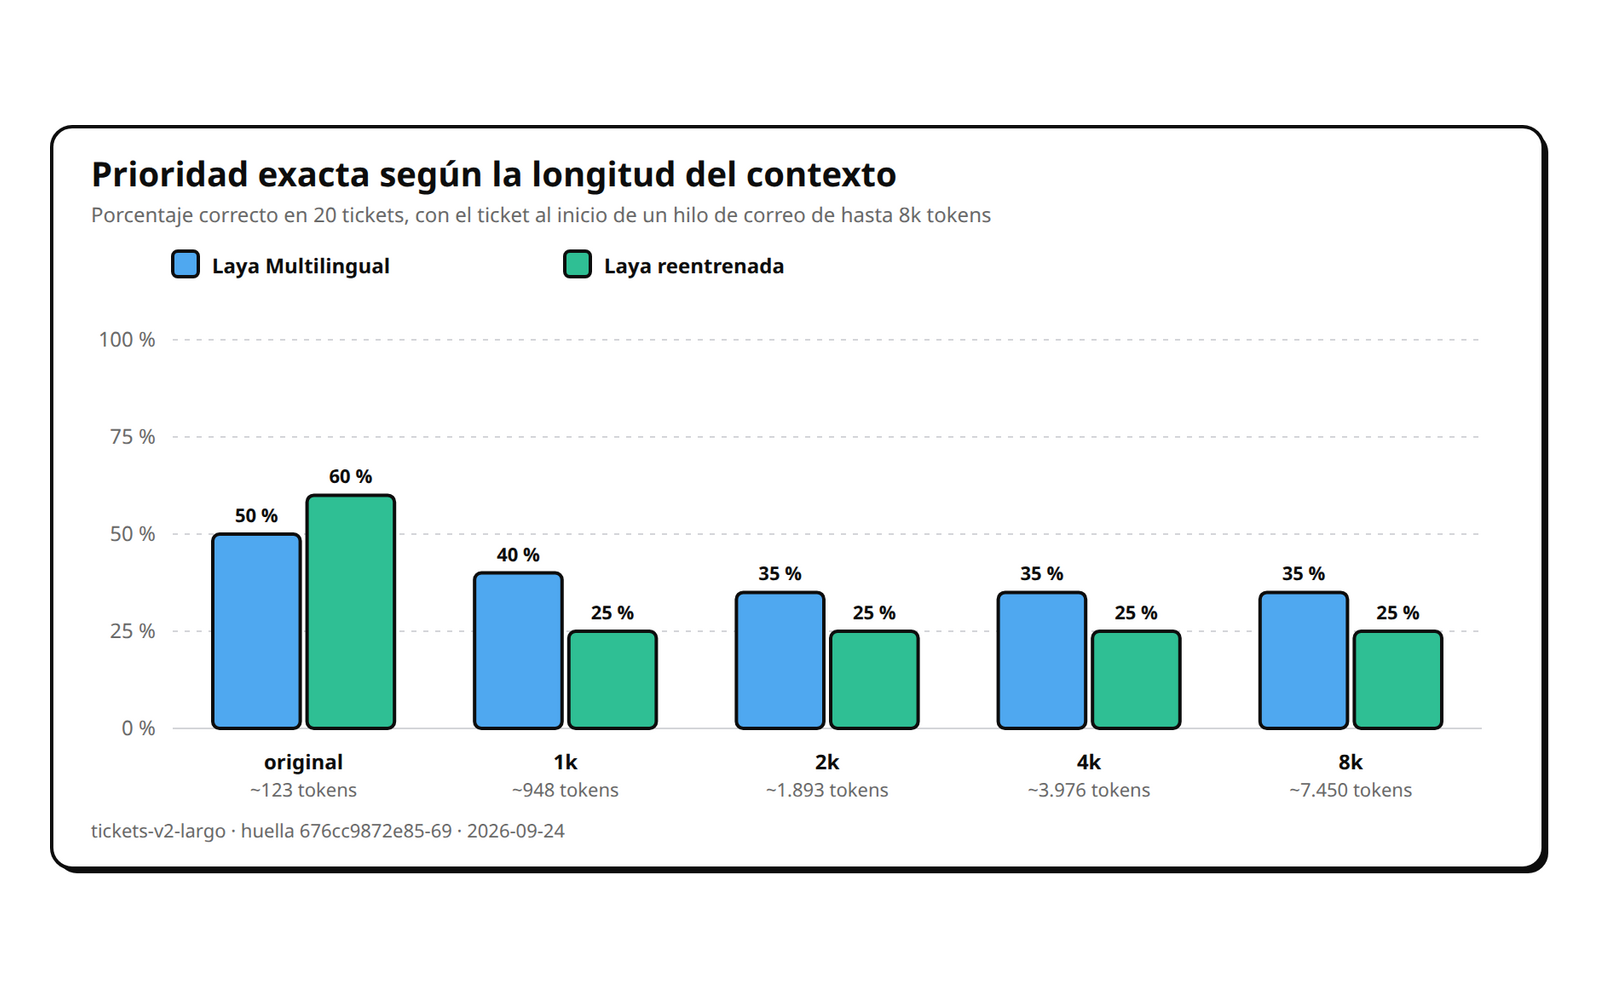
Y todo esto son 20 tickets y 120 solicitudes: sirve para ver hacia dónde va, no para prometer nada en producción. Las corridas están en System One Playground. La entrené con LayaFT, que ya se instala con pip; de eso va el próximo post. Si se les ocurre un ticket que la tumbe, cuéntenme.