 datzin
Cada skill, agente y regla que instalas en Claude Code se lee en cada mensaje, lo necesite o no la petición. Un par de colecciones y unas cuantas reglas suman miles de tokens de descripciones por turno: el contexto se llena antes y cada turno cuesta más. En el experimento de filtrar herramientas quería probar el orden contrario, decidir rápido antes de que razone el modelo grande. claude-decide es esa idea llevada a Claude Code.
Cómo funciona
Tus skills quedan en «solo nombre» y las reglas que elijas se mudan a una biblioteca. Cuando llega un mensaje, un modelo de 322M, Laya ajustada para esto, puntúa cada elemento instalado en una sola pasada: en GPU tarda como un cuarto de segundo para 50 elementos. Claude recibe la descripción completa solo de los pocos que encajan. En cada paso de herramienta (Bash npm test, Edit src/api.ts) vuelve a puntuar y agrega a lo mucho dos más. Todo corre en tu máquina: tus prompts no salen de ahí.
Detalle técnico: son dos hooks,
UserPromptSubmityPostToolUse, que le hablan a un daemon en127.0.0.1:7717con el modelo cargado una sola vez. Por cada elemento hace una preguntanoul: ¿esta skill sirve para esta petición? Las skills se recortan conskillOverrides: "name-only", y si el daemon no está o tarda, no se inyecta nada: nunca estorba.
Cuánto ahorra
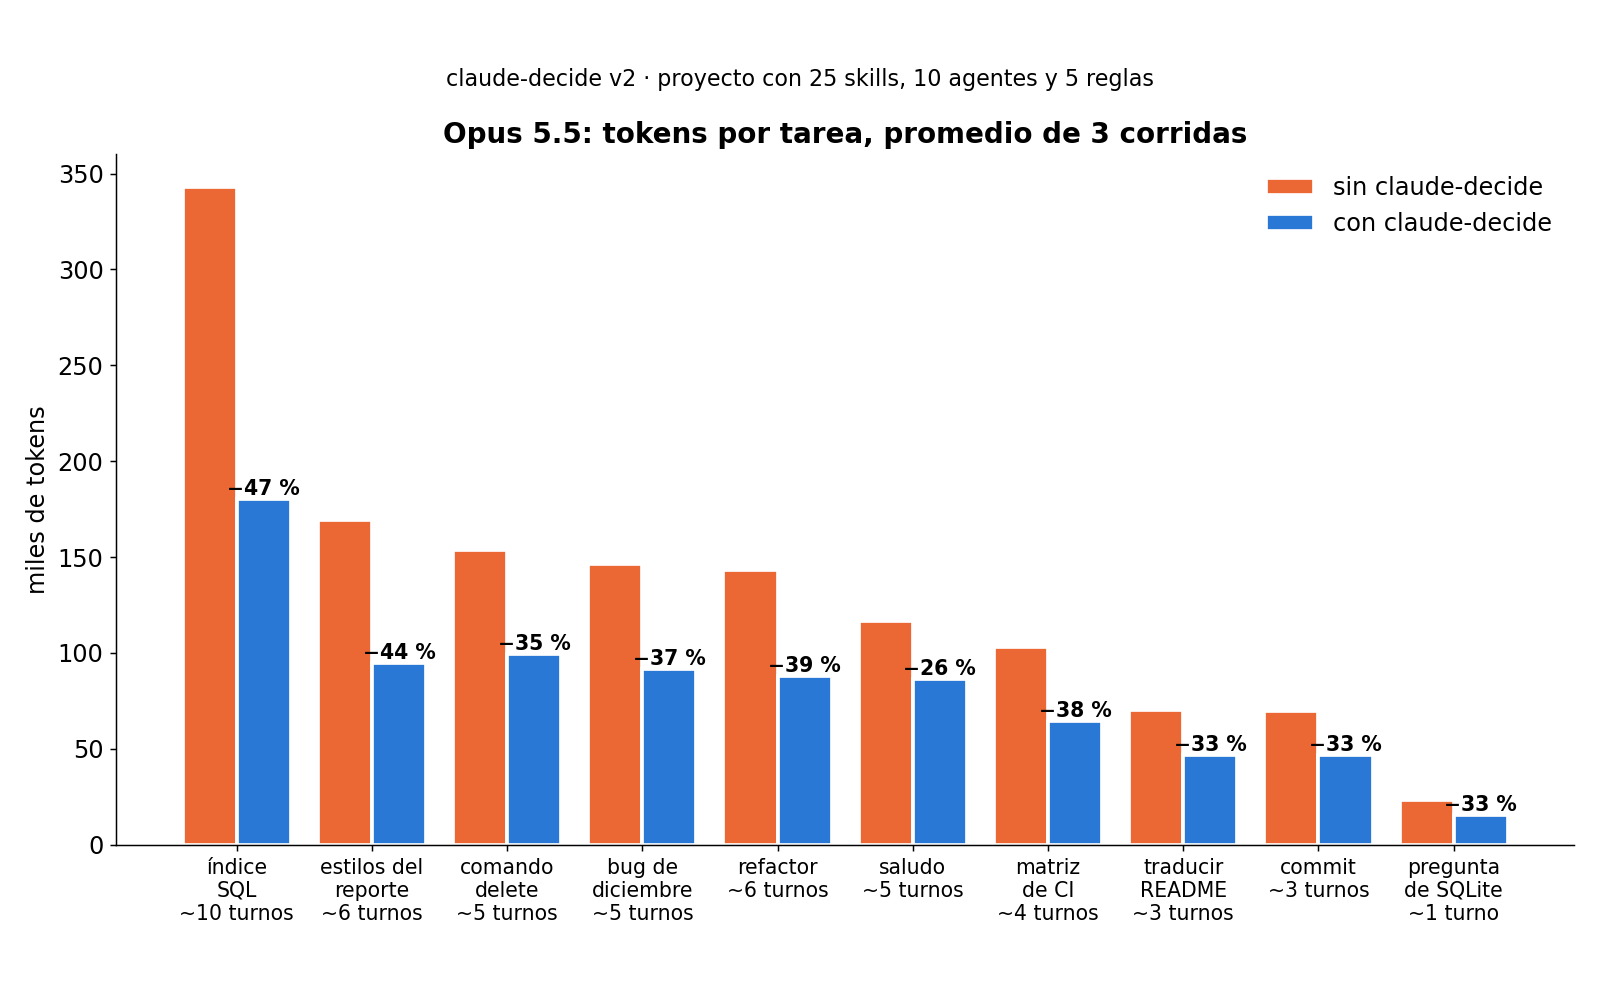
Lo medí con un proyecto chico (un CLI de gastos con tests, Dockerfile y CI) que trae lo que tendría alguien con un par de colecciones instaladas: 25 skills, 10 agentes y 5 reglas. Diez tareas reales, de arreglar un bug a traducir un README, tres veces cada una, sin y con el plugin.
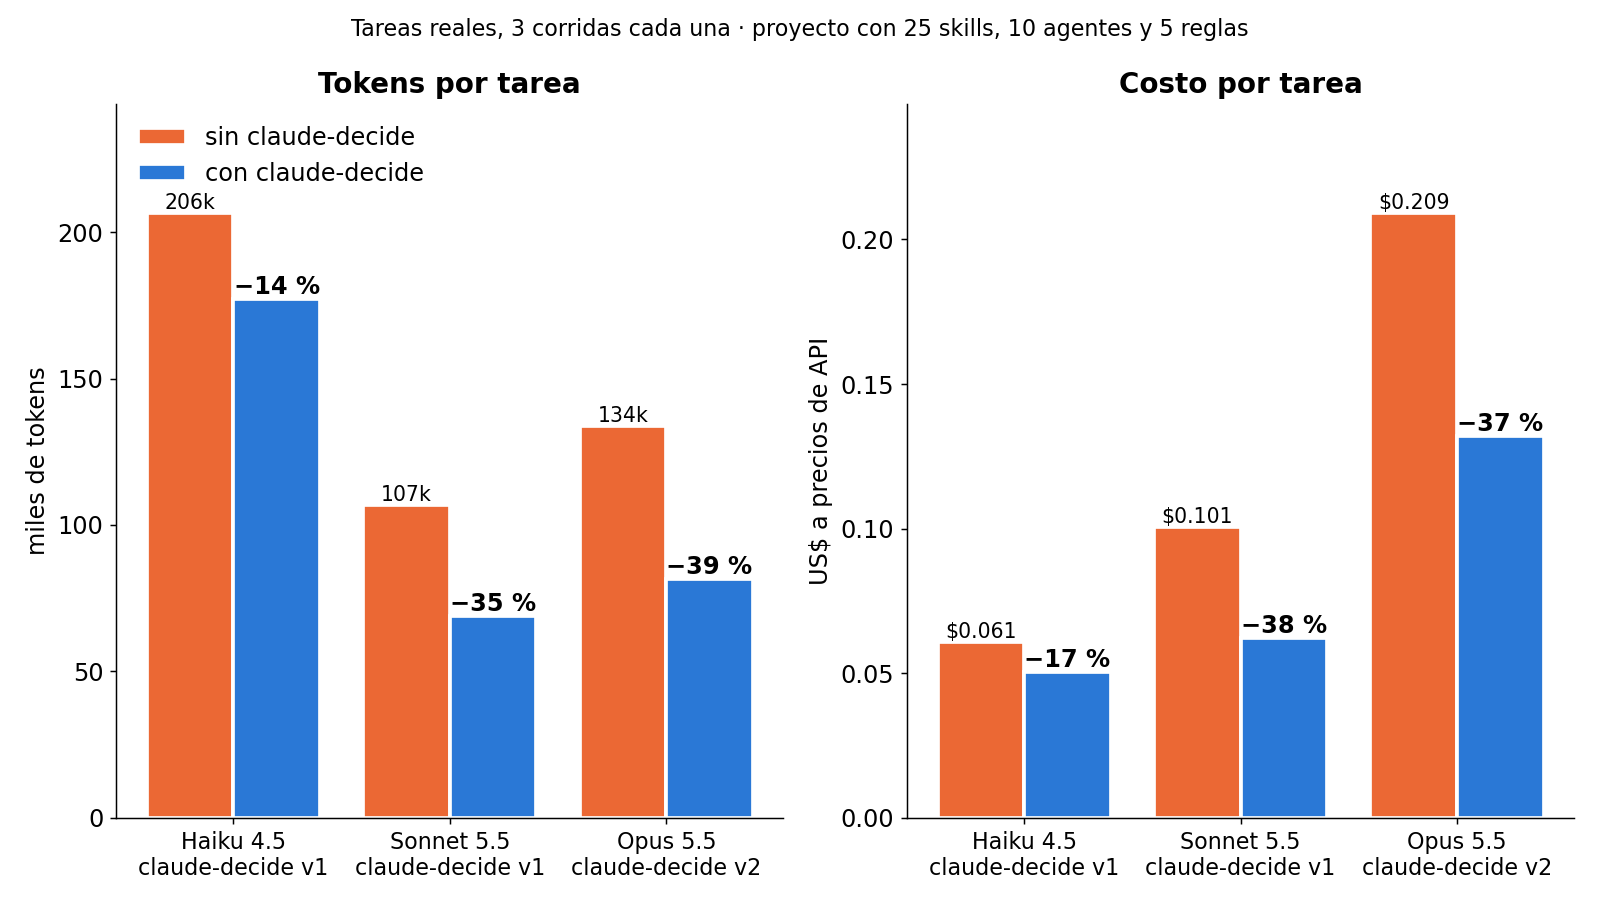
Con Opus 5.5, una tarea pasó en promedio de 134 mil a 81 mil tokens (−39 %) y de $0.209 a $0.132 (−37 %), y resolvió las 30 corridas en las dos condiciones. El ahorro no viene solo del mensaje: con menos ruido, Opus terminó en menos turnos (de 5.2 a 4.6 en promedio). Con Sonnet 5.5 bajó 35 % en tokens y 38 % en costo; con Haiku 4.5, 14 y 17 %. Y entre más cosas tengas instaladas, más ahorra: con 100 skills, 50 agentes y 15 reglas, un solo mensaje baja de 63 mil a 33 mil tokens.
Dónde se equivoca
También revisé qué eligió en cada decisión, contra lo que de verdad necesitaba cada tarea: un debugger y manejo de errores de Python para el bug, la skill de GitHub Actions para el CI, rendimiento de Python para la consulta lenta, y nada para el resto. Al llegar el mensaje, la v2 del modelo mejoró mucho: mete un elemento equivocado en el 17 % de los mensajes, contra 42 % de la v1.
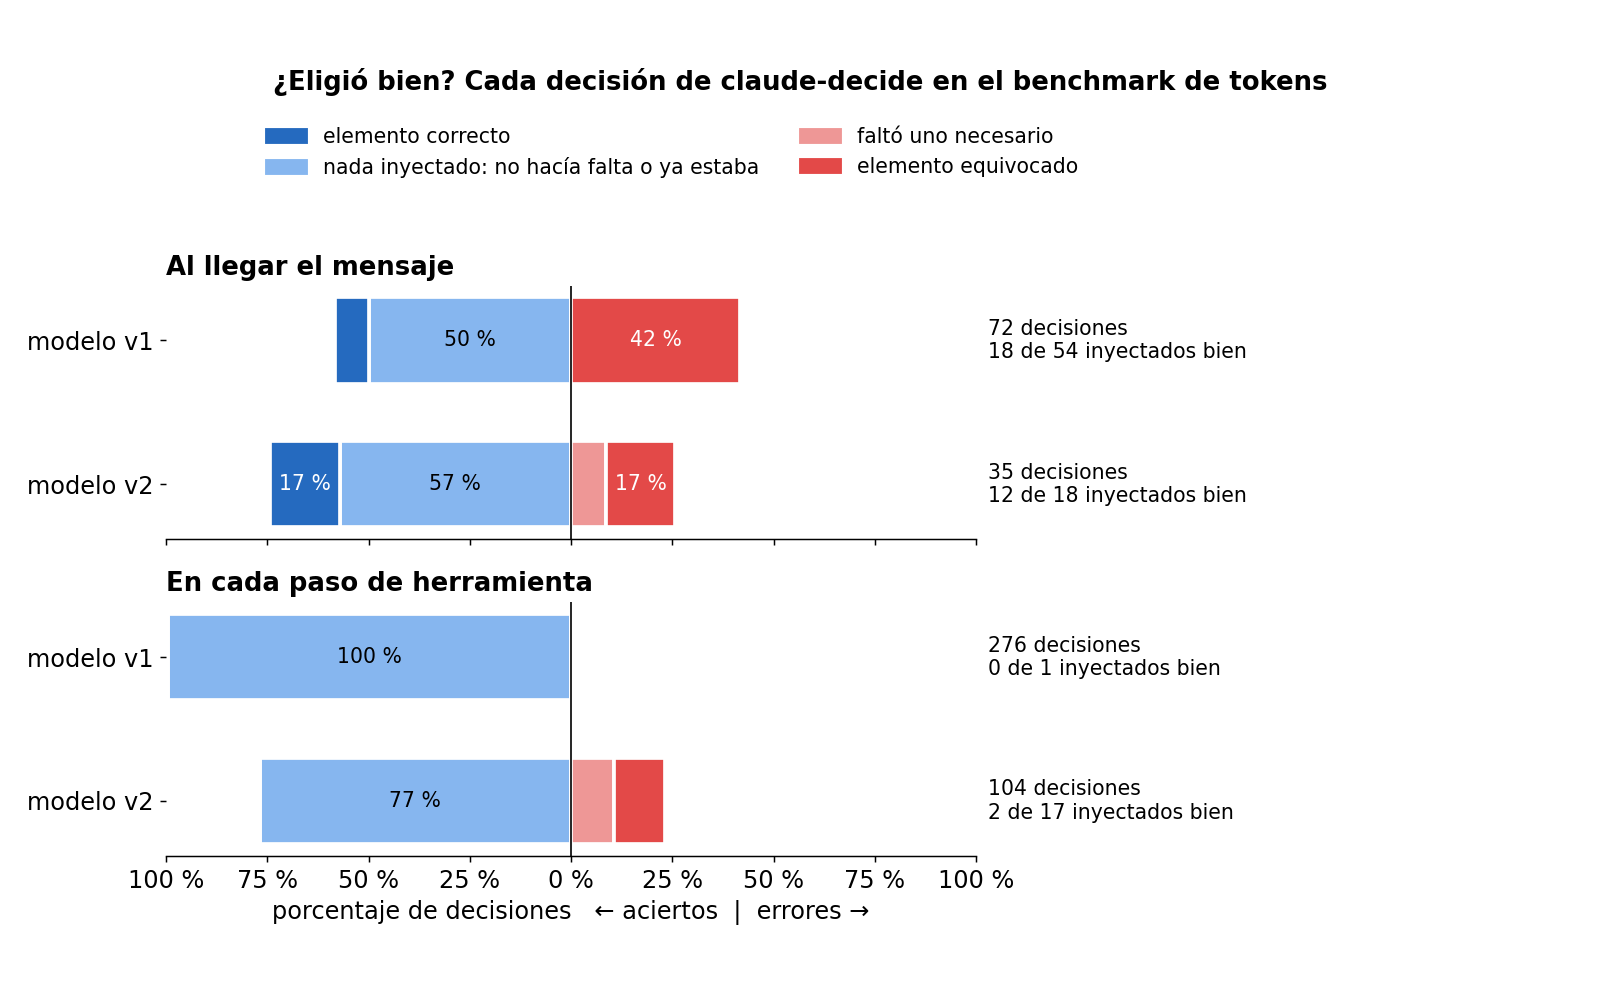
En los pasos de herramienta, en cambio, empeoró: la v1 inyectó una sola vez en 276 pasos; la v2 inyecta en 13 de 104, y 15 de esos 17 elementos están mal. Casi todos son el mismo agente, ruby-pro, en un proyecto de Python: el modelo ve la petición y el paso, pero no sabe en qué lenguaje está el proyecto.
No le pega a las respuestas, porque el ahorro sale de recortar y lo inyectado es una red de seguridad, pero es ruido que no debería estar. Y un límite más: en CPU tarda unos 4.6 s para 49 elementos y el hook se rinde a los 3 s, así que sin GPU solo ayuda con catálogos chicos.
El código está en GitHub y el modelo en Hugging Face, los dos abiertos. Instálenlo, y si les recomienda un agente de Ruby en su proyecto de Python, ya saben por qué; cuéntenme qué más le encuentran. En el próximo post cuento cómo se entrenó el modelo.