 datzin
La primera vez que escribí «estoy enamorado» en mi app, la canción principal fue «Creep» de Radiohead. En ese momento dejé de agregar funciones y empecé a medir.
La app es Resonance, una herramienta autohospedada que arma playlists de Spotify con tu propia biblioteca a partir de una frase libre sobre cómo te sientes. Mi plan original era usar las características de audio de Spotify (energía, valencia, tempo), pero audio-features y recommendations devuelven 403/404 para las apps creadas después de noviembre de 2024. Así que cambié la entrada: si la app no puede escuchar la música, puede leerla. Las canciones se clasifican por su letra con Laya, un modelo de decisión de código abierto (Apache 2.0) que corre en CPU y nunca se entrenó con música ni con emociones.
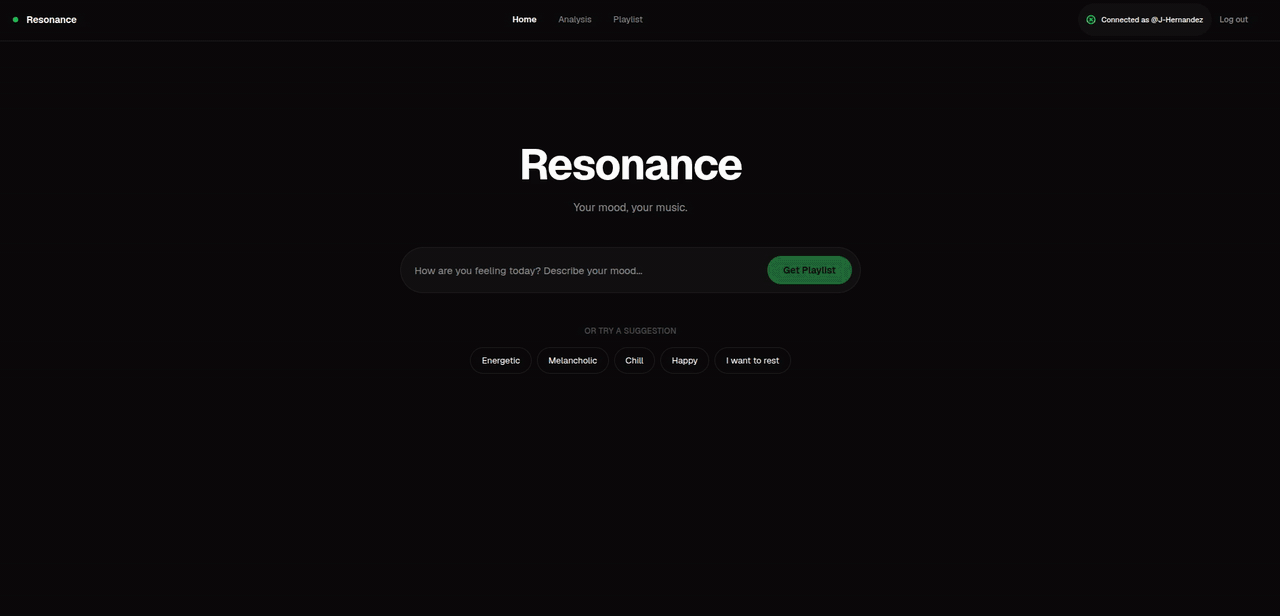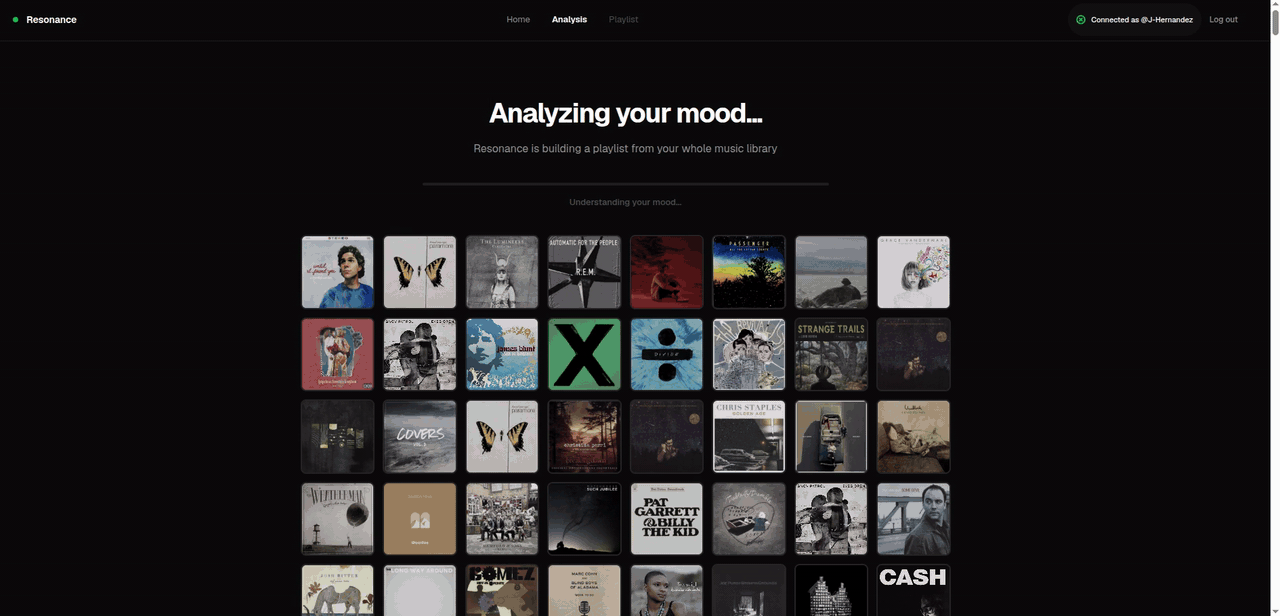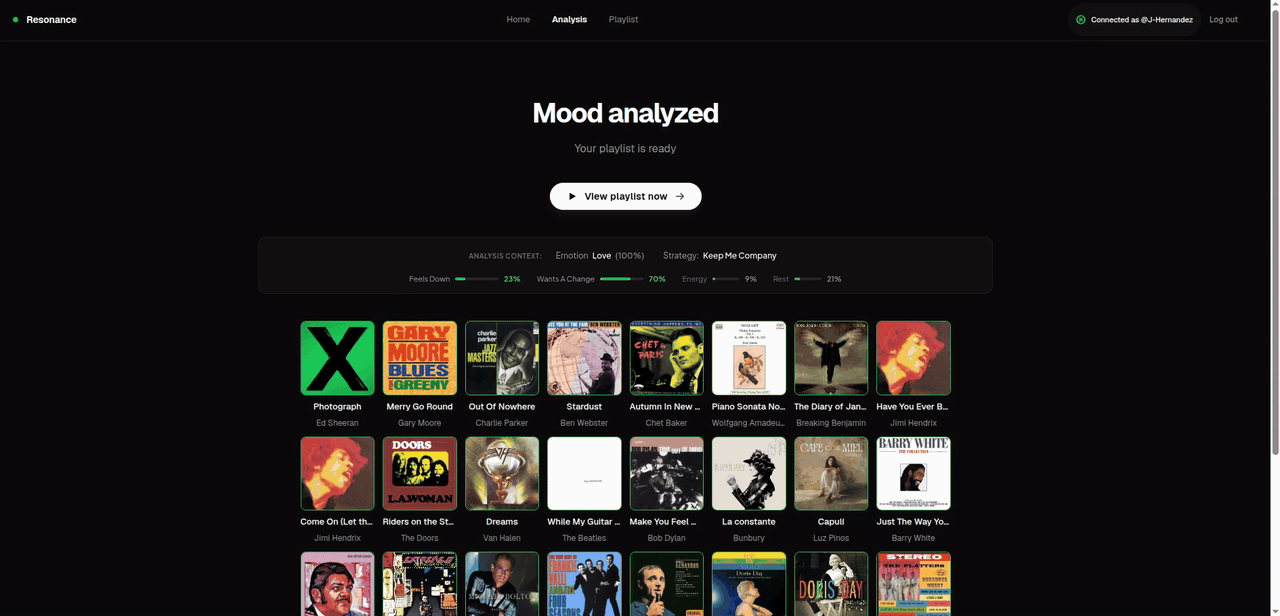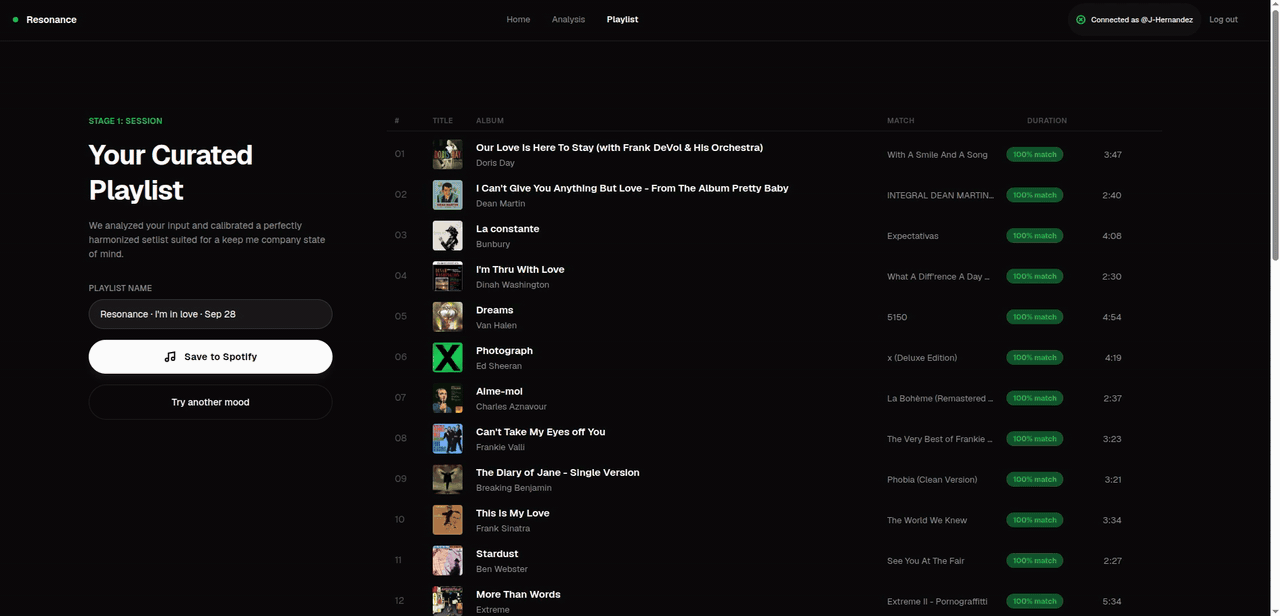
Este artículo recorre la arquitectura, la interfaz del modelo, cómo se eligen las canciones y cómo lo evalué, incluidas las partes que no funcionaron. El código está en github.com/JoseVelazcoH/Resonance.
Arquitectura
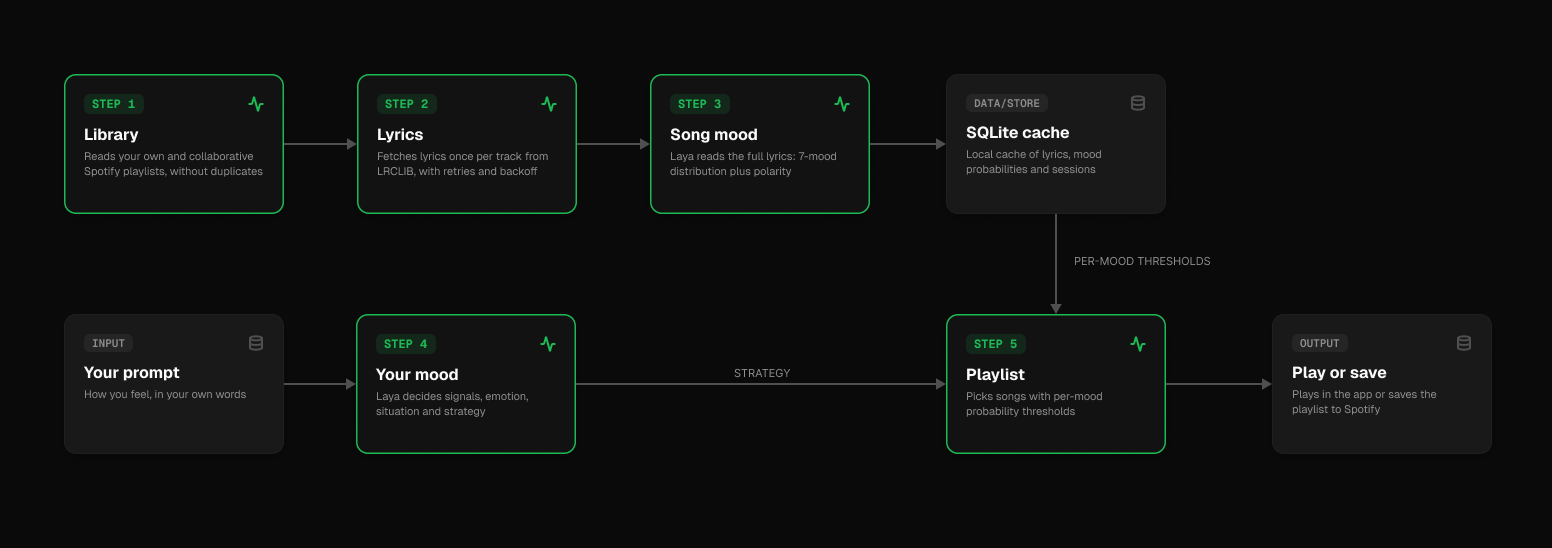
Hay dos fases con costos muy distintos:
| Fase | Cuándo | Trabajo |
|---|---|---|
| Preparar la biblioteca | Una vez por canción | Obtener la letra, correr Laya y guardar la distribución completa de probabilidades |
| De la frase a la playlist | En cada solicitud | Correr Laya solo sobre la frase y filtrar los perfiles guardados |
Mi primera versión volvía a leer todas las letras en cada solicitud y tardaba unos diez minutos. Mover el trabajo caro a una preparación única, como un índice de búsqueda, lo bajó a segundos sin importar el tamaño de la biblioteca.
El backend es hexagonal (FastAPI, domain / application / ports / adapters). Laya, Spotify, LRCLIB y SQLite son adaptadores detrás de puertos, y las pruebas unitarias corren con dobles (sin red y sin modelo).
La interfaz del modelo
Un modelo de decisión no genera texto. Recibe un estado (texto) y preguntas tipadas, y devuelve probabilidades calibradas en una sola pasada. Son dos preguntas por canción, agrupadas con predict_batch:
questions = {
    "mood": {
        "type": "choice",
        "instructions": "Identify the primary emotional response triggered by these song lyrics.",
        "criteria": {
            "love": "...", "happiness": "...", "comfort": "...", "sadness": "...",
            "loneliness": "...", "anger": "...", "fear": "...",
        },
    },
    "polarity": {
        "type": "noul",
        "instructions": "Are these song lyrics emotionally positive overall?",
    },
}

results = router.predict_batch([
    {"state": lyrics, "questions": questions, "max_len": 1024}
    for lyrics in batch
])
# results[i]["answers"]["mood"]["probabilities"] -> {"love": 0.56, "sadness": 0.28, ...}
Las decisiones de diseño que importaron:
- Letra completa, en texto plano. Para ahorrar cómputo, al principio mandaba un fragmento de 500 caracteres elegido con una heurística para «encontrar el coro». La había probado por velocidad, nunca por calidad. Con todo lo demás fijo, la letra completa subió la exactitud de ánimo en el piloto de 30% a 50%. Le estaba echando la culpa al modelo por una decisión que tomé en el pipeline.
- Etiquetas planas, máximo 10 opciones. Empecé con un árbol de 260 emociones, una pregunta por nivel. Para «estoy enamorado», la primera rama fue prácticamente un empate (0.53 ambivalente contra 0.43 positivo); se fue por ambivalente y amor quedó inalcanzable. Los errores se acumulan en cada rama. Además, las preguntas
choicecon más de 10 opciones pierden calibración. - Guardar la distribución, no el argmax. La selección trabaja directo sobre
p(ánimo), y eso es lo que permite umbrales por ánimo. - Versionar el perfil. La versión del perfil es un hash del catálogo de ánimos más la redacción de las preguntas, así que cambiar cualquiera invalida la caché en vez de mezclar perfiles incompatibles.
Selección: un umbral por ánimo
Los sesgos del modelo no son uniformes: sobrepredice love y casi nunca elige happiness. Un solo corte global o llena las playlists de canciones de «amor» o no encuentra ninguna feliz. Cada ánimo tiene su propio umbral, guardado como datos (mood_selection_policy.json), no como código:
{
  "love": 0.72, "happiness": 0.08, "comfort": 0.18,
  "sadness": 0.14, "loneliness": 0.16, "anger": 0.50,
  "fear": null
}
def qualifies(track: TrackMoodProfile, mood_id: str, policy: MoodSelectionPolicy) -> bool:
threshold = policy.threshold_for(mood_id)
if threshold is None: # no reliable threshold: require the top-1 mood
return track.mood_id == mood_id
return keep_probability(track, mood_id) >= thresholdLa regla de ajuste por ánimo: maximizar F0.5 con la condición de que la precisión supere a la línea base aleatoria por al menos 0.15 y el recall sea de al menos 0.20. Prioriza la precisión a propósito: una playlist más corta que encaja es mejor que una larga que no. fear nunca pasó la barra, así que recurre al ánimo principal.
Evaluación
Un piloto con 30 canciones me dio 83% en positivo contra negativo y 50% en ánimo. No sobrevivió a un conjunto más grande, por eso todo lo que sigue sale de una partición bien hecha.
Datos. 300 canciones de mis propias playlists, cada una etiquetada con un ánimo principal y ánimos adyacentes aceptables. Se dividieron 50/50 en DEV y TEST, estratificadas por ánimo, idioma y origen de la etiqueta, con todas las versiones de una misma canción del mismo lado para evitar fugas. Los umbrales se ajustaron solo con DEV.
Clasificación de ánimo (las 300 canciones):
| Métrica | Laya | Elección aleatoria |
|---|---|---|
| Ánimo exacto | 31% | 14% |
| Ánimo exacto o adyacente | 55% | 29% |
Positivo contra negativo (noul) | 52% | 54% (siempre «negativo») |
La pregunta de polaridad no aporta señal, así que no se usa para seleccionar.
Benchmark externo. MERGE es un dataset público de letras etiquetado por personas en los 4 cuadrantes de Russell. La distribución de 7 ánimos de Laya se mapea a cuadrantes (el mapeo de love se eligió con la partición de validación) y se evalúa en la de prueba:
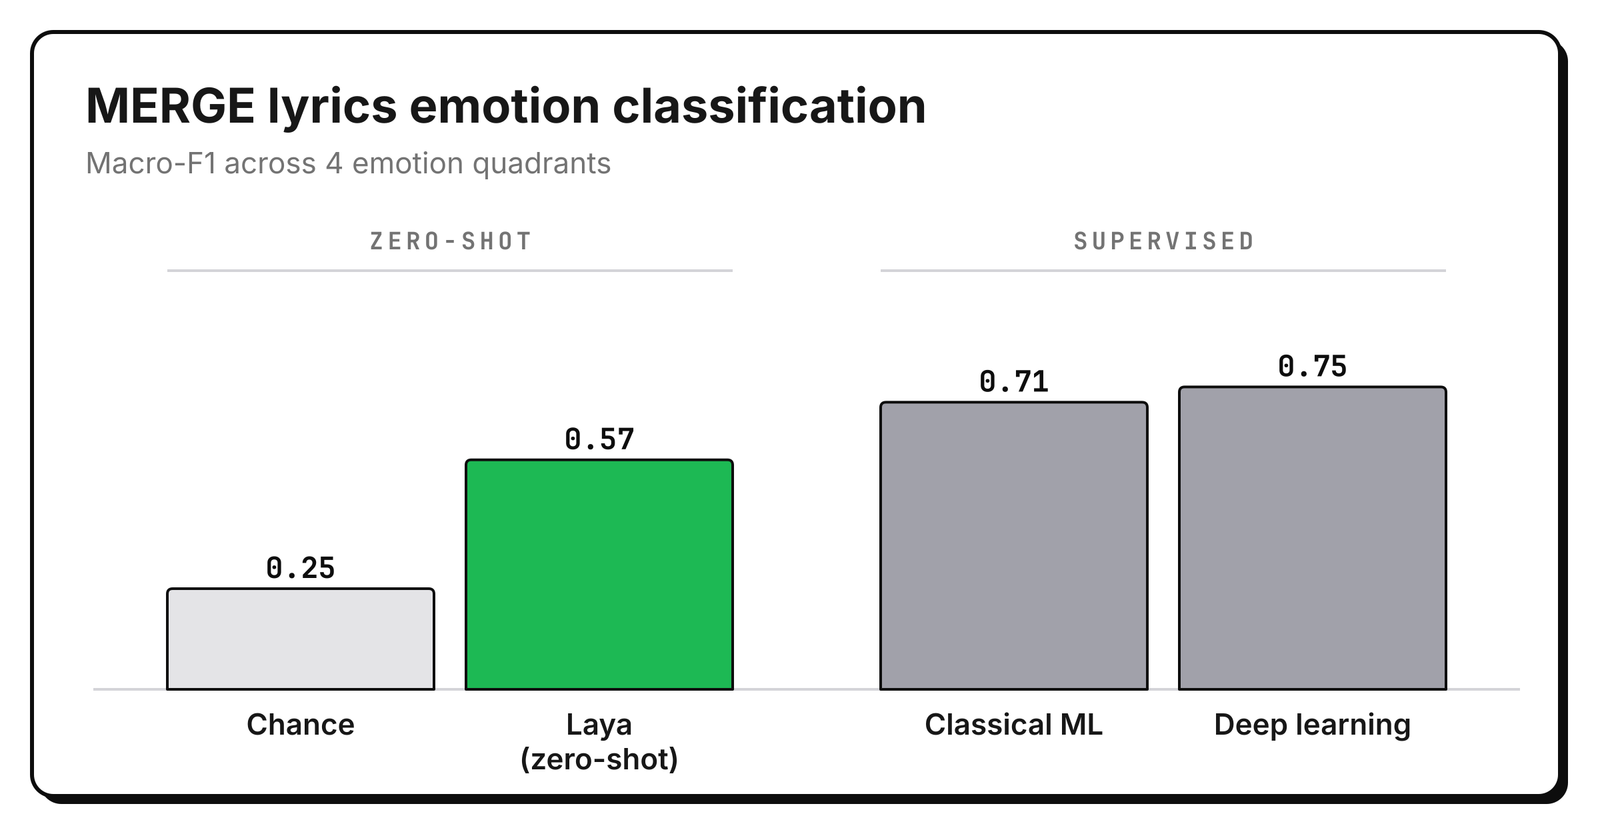
Sin entrenamiento, alcanza 0.57 de macro-F1 contra 0.71 a 0.75 de los modelos entrenados con MERGE. Hacer directamente una pregunta de 4 cuadrantes dio menos (51.9% de exactitud) que mapear los 7 ánimos (57.5%).
Selección de playlists (partición TEST reservada): la precisión promedio es de 48% contra una línea base aleatoria de 32%, con un recall promedio de 33%.
Lo que no ayudó. Nada de esto superó a la pregunta simple de 7 ánimos en DEV: una pregunta noul por ánimo en lugar de un solo choice, preguntas de lo general a lo particular, criterios más detallados, una etiqueta de idioma en el estado, mandar las letras en inglés al checkpoint en inglés y recalibrar después. Una línea base con roberta-base-go_emotions mapeada a los mismos ánimos también quedó por debajo de Laya. El techo parece estar en la señal que hay en las letras, no en el diseño de las preguntas.
Lo que me llevo
- Mide antes de construir más. Cada cambio de arquitectura del que me siento orgulloso llegó después de un número, no antes.
- Sospecha de tu pipeline antes que de tu modelo. La heurística del fragmento costó más exactitud que cualquier elección de modelo.
- Guarda distribuciones, no etiquetas. Los umbrales por ánimo existen solo porque la distribución completa estaba en caché.
- Los modelos de decisión no leen emociones, pero sin entrenamiento ya traen una señal real sobre la que se puede construir.
Notas sobre la API de Spotify (modo desarrollo, 2026)
Cosas que me costaron tiempo:
GET /tracks?ids=(en lote) devuelve 403. UsaGET /tracks/{id}.- Los elementos de una playlist salen de
/playlists/{id}/items(llaveitem); la ruta vieja/tracksdevuelve 403. - Las playlists que no son tuyas ni colaborativas devuelven 403, y las editoriales devuelven 404.
- La URI de redirección debe usar
127.0.0.1, nolocalhost, y la cookie de sesión tiene que coincidir. - El Web Playback SDK necesita Premium y los scopes
streaming,user-read-email,user-read-private,user-read-playback-stateyuser-modify-playback-state. Las canciones pueden reenlazarse a otro ID, así que conviene identificar la que suena primero por ID y luego por nombre y artista normalizados.
Stack
Python 3.11 (FastAPI, uv), SQLite en modo WAL con una conexión compartida por archivo, React + TypeScript (Vite), el checkpoint multilingüe de Laya en CPU y LRCLIB con reintentos, backoff y circuit breaker.
git clone https://github.com/JoseVelazcoH/Resonance.git
cd Resonance
make install   # uv sync + npm install, crea los archivos .env
make dev       # API en :8000, app web en :5173
make test      # pruebas unitarias, sin red y sin modelo
Requiere Spotify Premium y una app de desarrollador de Spotify. La primera ejecución descarga y perfila todas las canciones de tu biblioteca; las siguientes solo procesan las nuevas.