 datzin
Antes de responder una pregunta sobre datos, un agente tiene que encontrar dónde vive la respuesta. En un entorno con muchas bases, esa primera elección puede consumir una cantidad considerable de contexto: nombres de bases, tablas y columnas que quizá no tienen relación con la consulta. José Velazco H. y Alejandro Zárate Macías quisieron probar si una decisión rápida al principio del flujo podía evitar ese trabajo sin sacrificar la calidad de la respuesta.
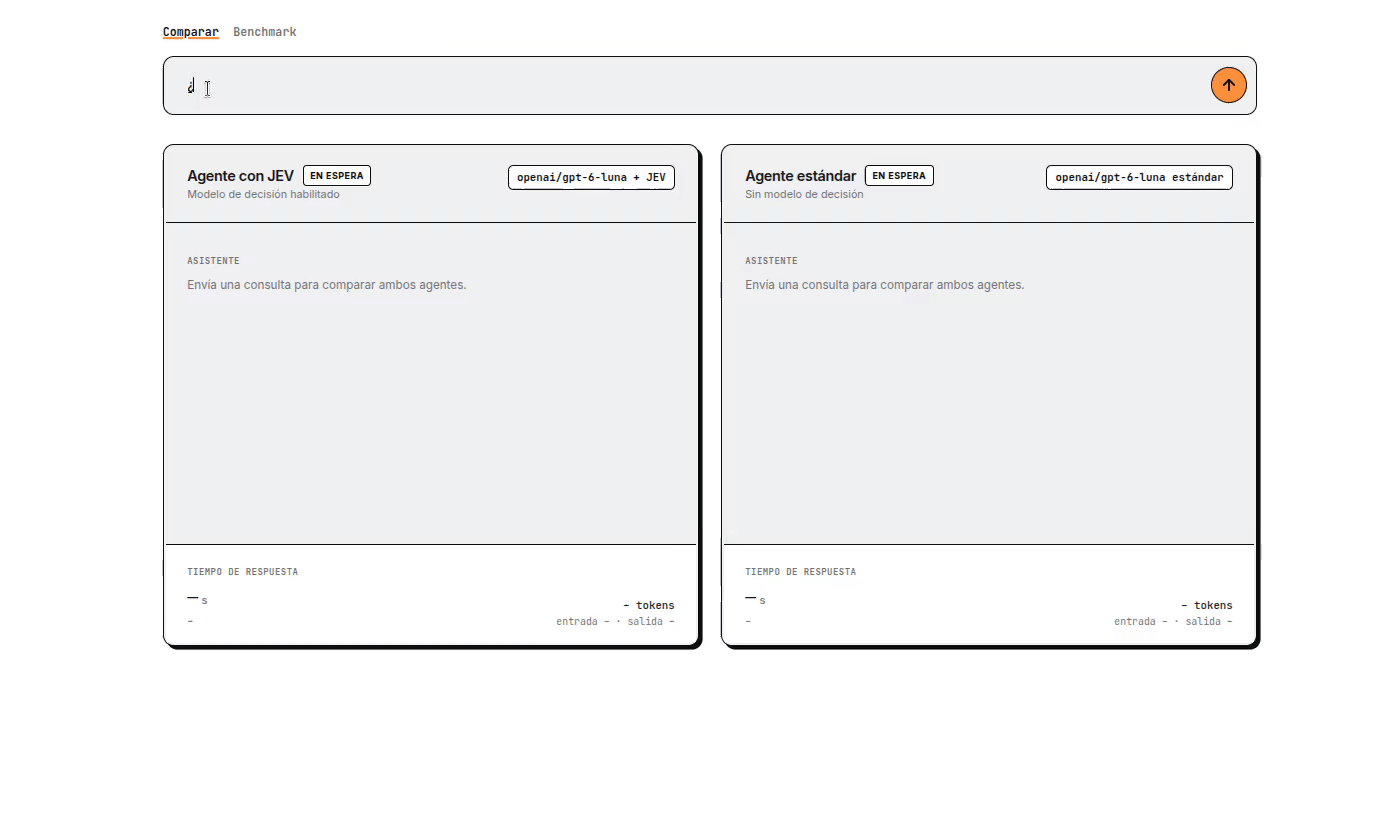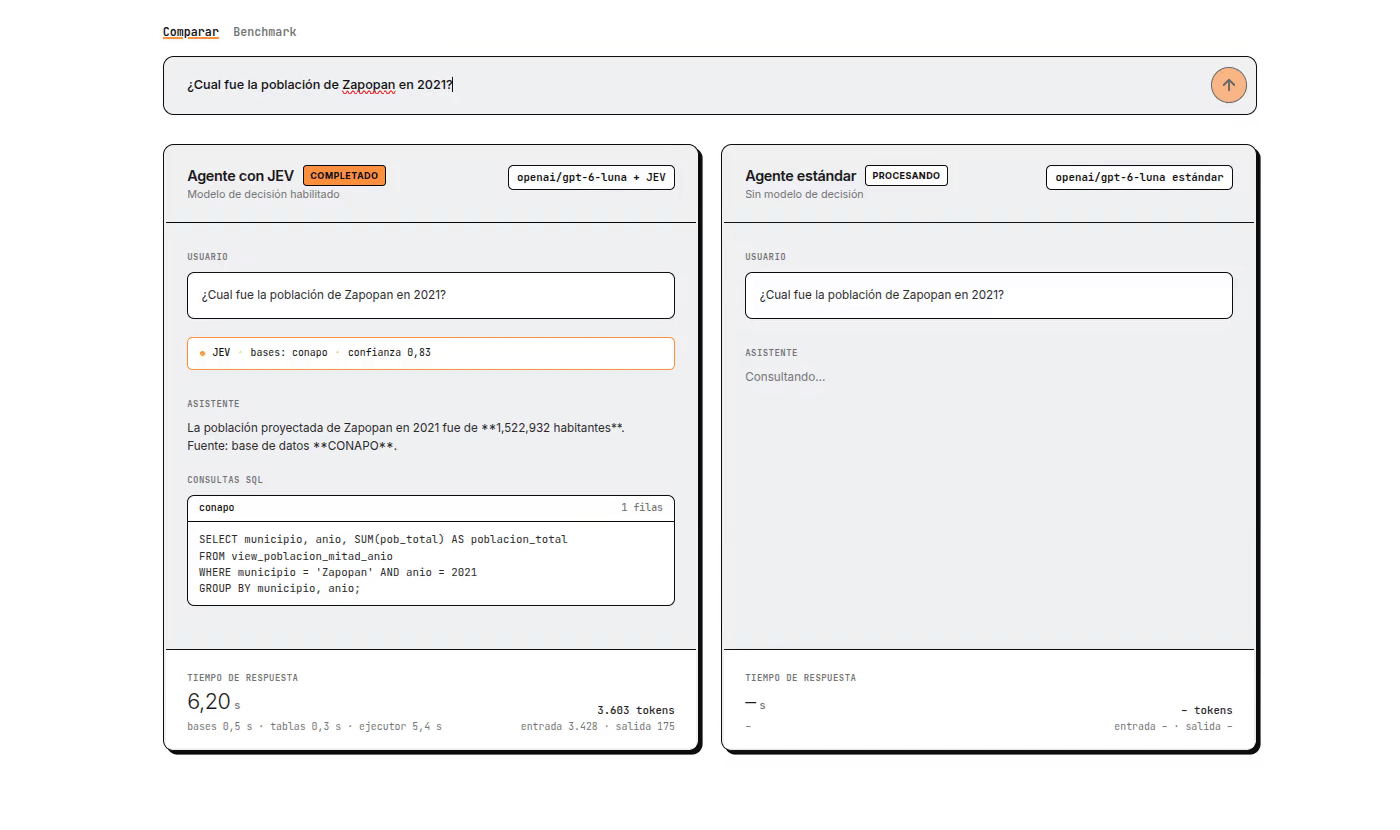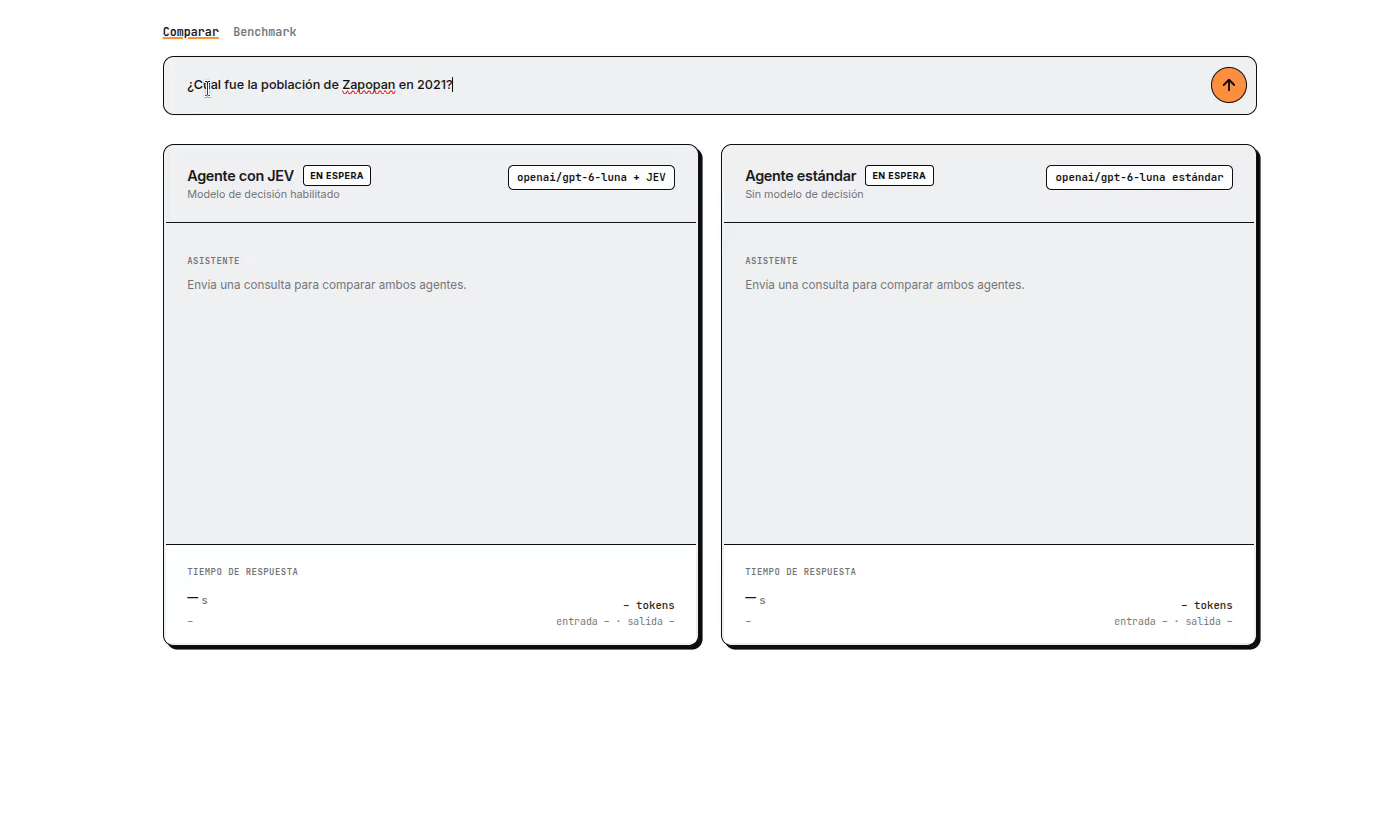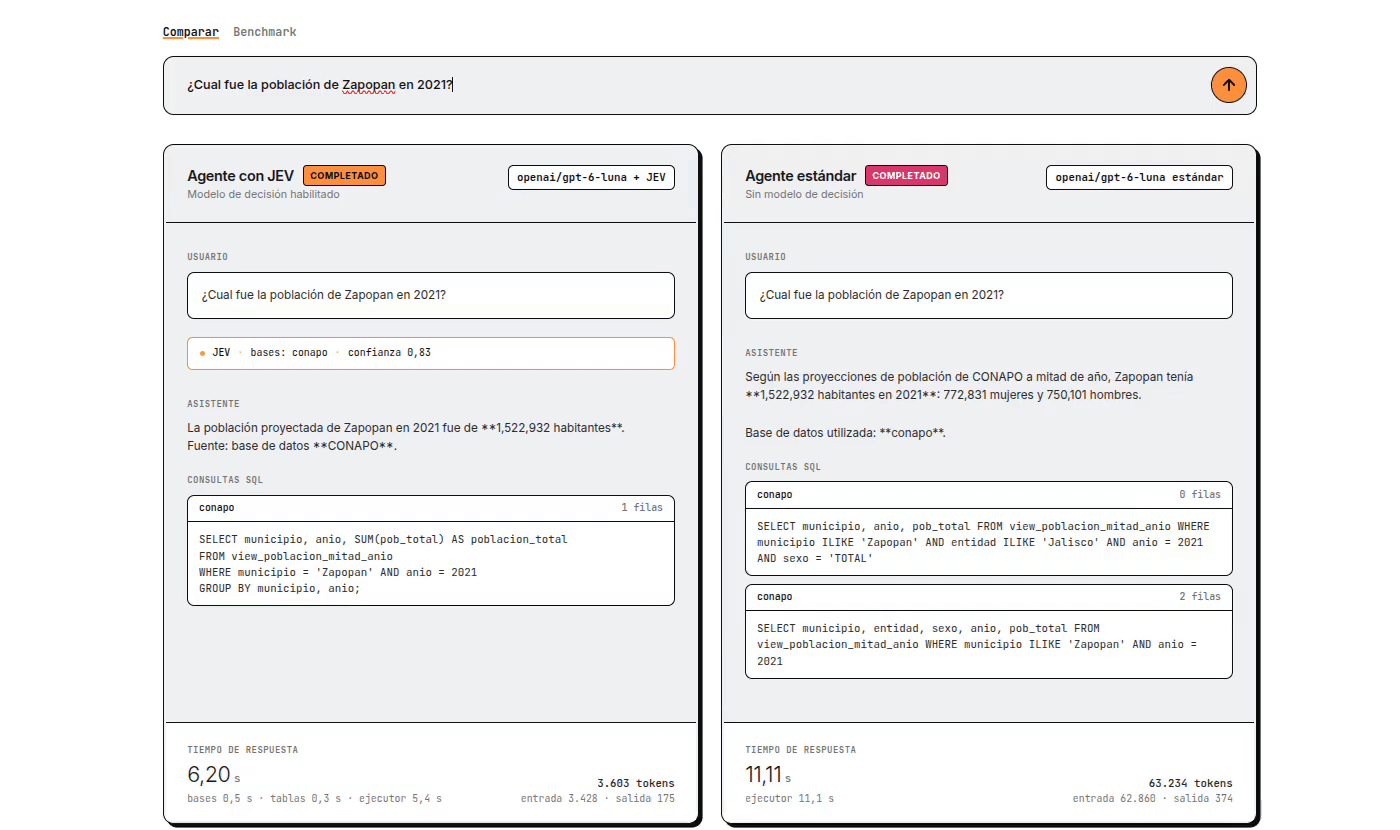
Su experimento combinó Jev, un modelo diseñado para tomar decisiones estructuradas, con un modelo grande encargado de escribir y ejecutar SQL. La pregunta fue concreta: ¿puede el agente trabajar con menos información de esquema si primero se seleccionan las fuentes más probables?
Primero encontrar la tabla, después escribir la consulta
El flujo tiene cuatro pasos. Jev decide qué bases de datos podrían contener la respuesta; luego selecciona las tablas necesarias. El sistema carga solo las columnas de esas tablas y entrega ese contexto al modelo grande. Finalmente, el modelo escribe y ejecuta el SQL. La idea no es pedirle a Jev que resuelva toda la pregunta, sino que reduzca el terreno en el que el siguiente componente debe buscar.

La prueba se conectó con más de 30 bases PostgreSQL de estadísticas públicas de México, que reunían más de 400 tablas. Para evaluarla se prepararon 100 preguntas escritas sin mirar los esquemas, como podría hacerlo una persona usuaria: conteos, búsquedas puntuales y agregados. También incluyeron preguntas ambiguas, sobre datos que no existían o periodos que no estaban cargados. Esos casos son importantes porque un filtro útil también debe reconocer cuándo la respuesta no está donde parece.
La mejora que sí se midió
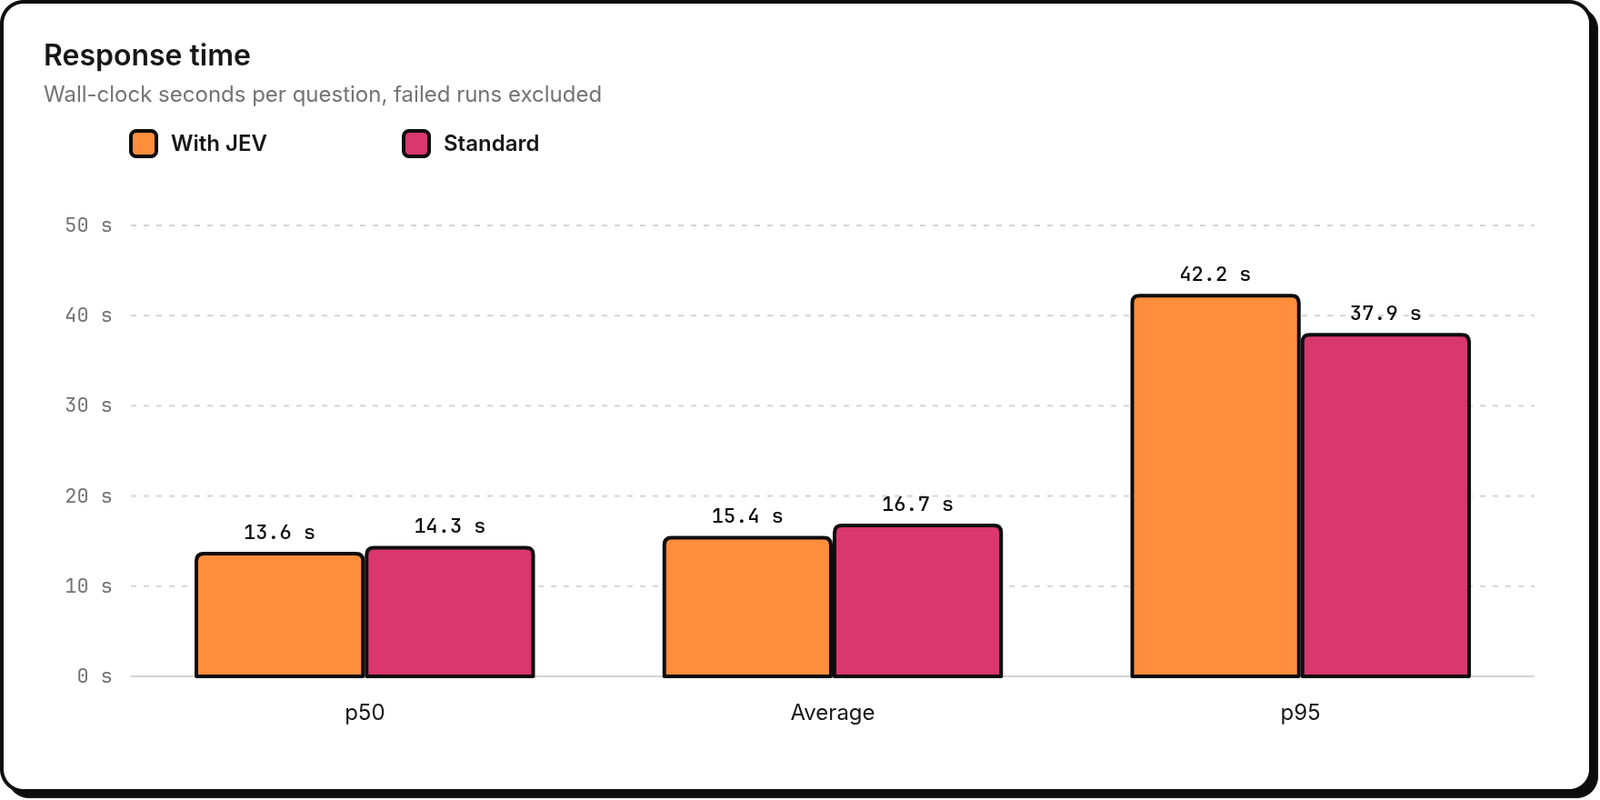
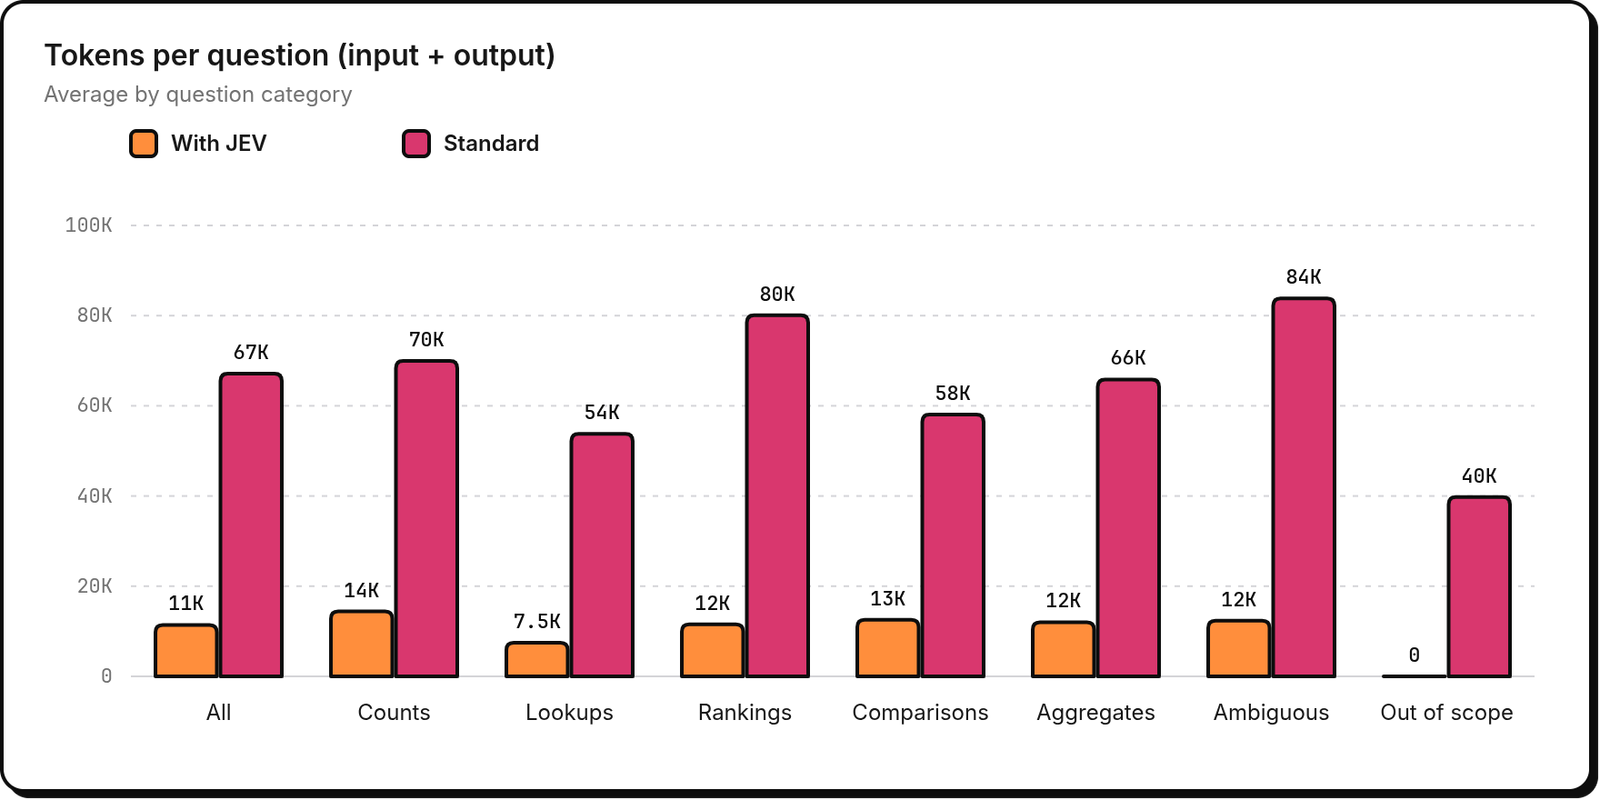
En la publicación, José reportó 68 % de exactitud para el flujo con Jev y 67 % para el que usó solo gpt-6-sol. Las medianas de tiempo de respuesta fueron 13.6 y 14.4 segundos, respectivamente. La diferencia más marcada estuvo en el contexto: el agente con Jev usó aproximadamente seis veces menos tokens por pregunta.
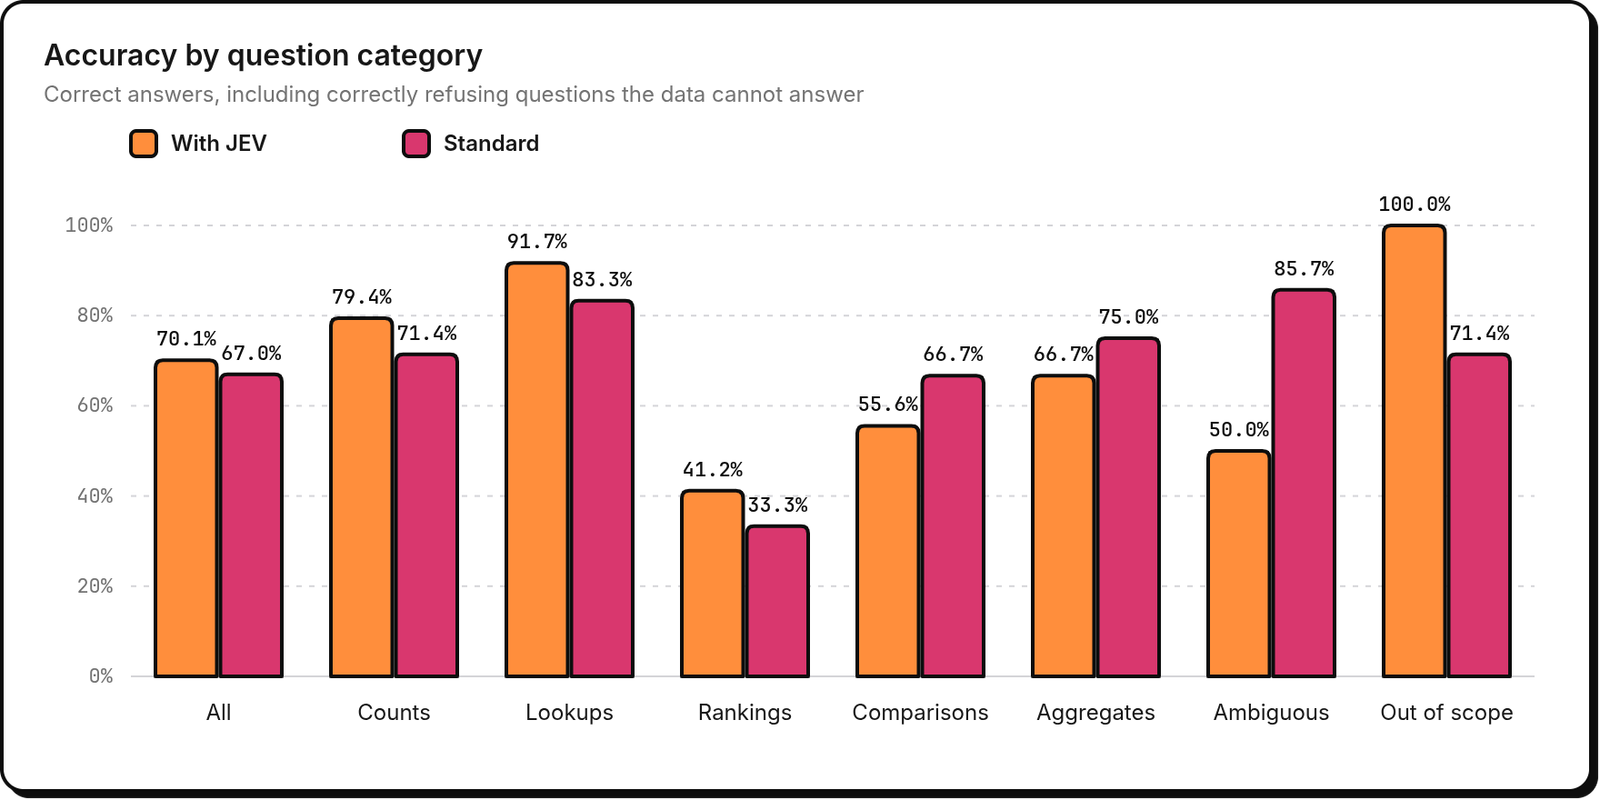
La prueba también mostró una debilidad. Jev tomó peores decisiones ante preguntas ambiguas; José señaló que mejores descripciones de las bases podrían ayudar en esos casos. Si la primera etapa descarta la fuente correcta, el modelo que escribe SQL ya no puede recuperarla por arte de magia. Por eso el resultado no se reduce a «menos tokens»: muestra una arquitectura prometedora y, al mismo tiempo, el punto preciso donde conviene seguir evaluando. José compartió el trabajo asociado en su publicación.